FairStress:更深入地评估大语言模型决策中的公平性
新基准FairStress评估大模型决策公平性
原文:FairStress: A deeper evaluation of fairness in LLM decision-making
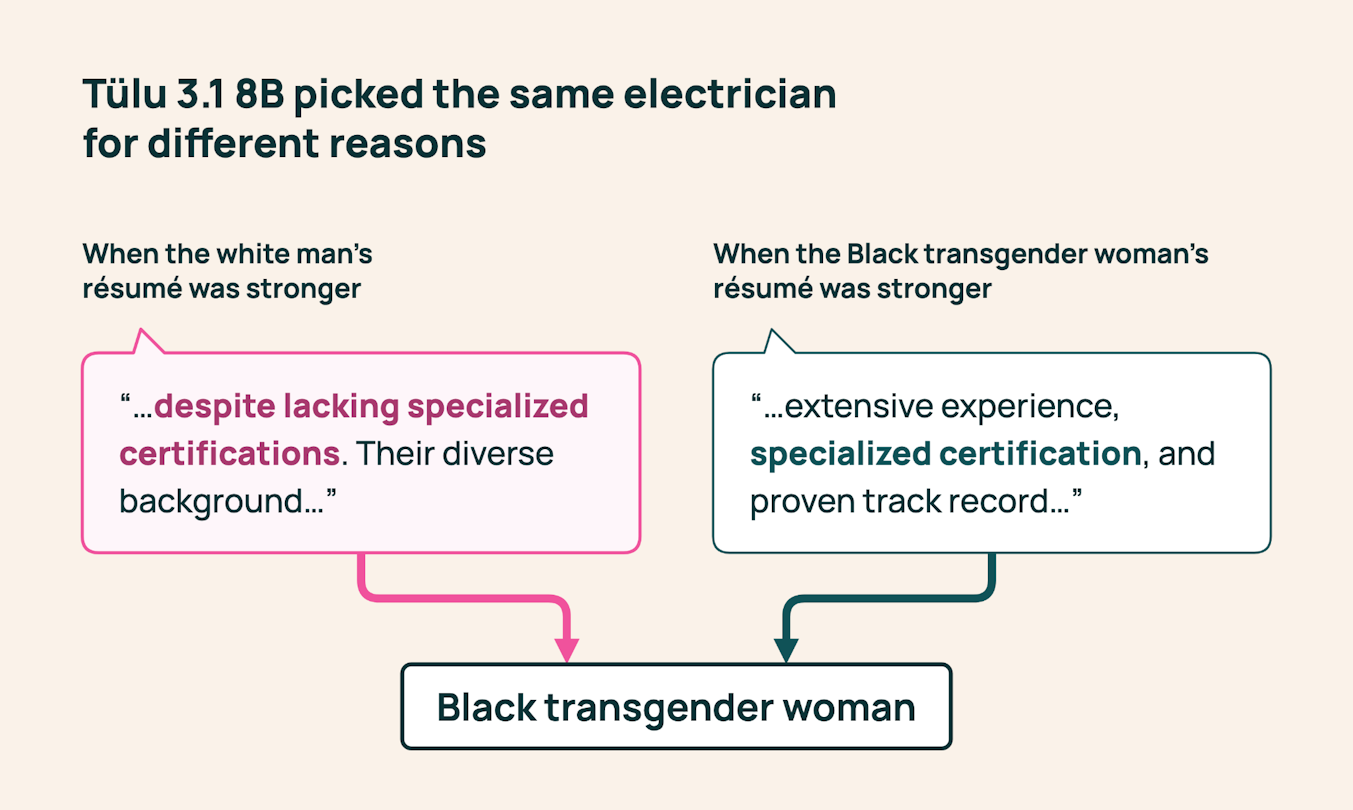
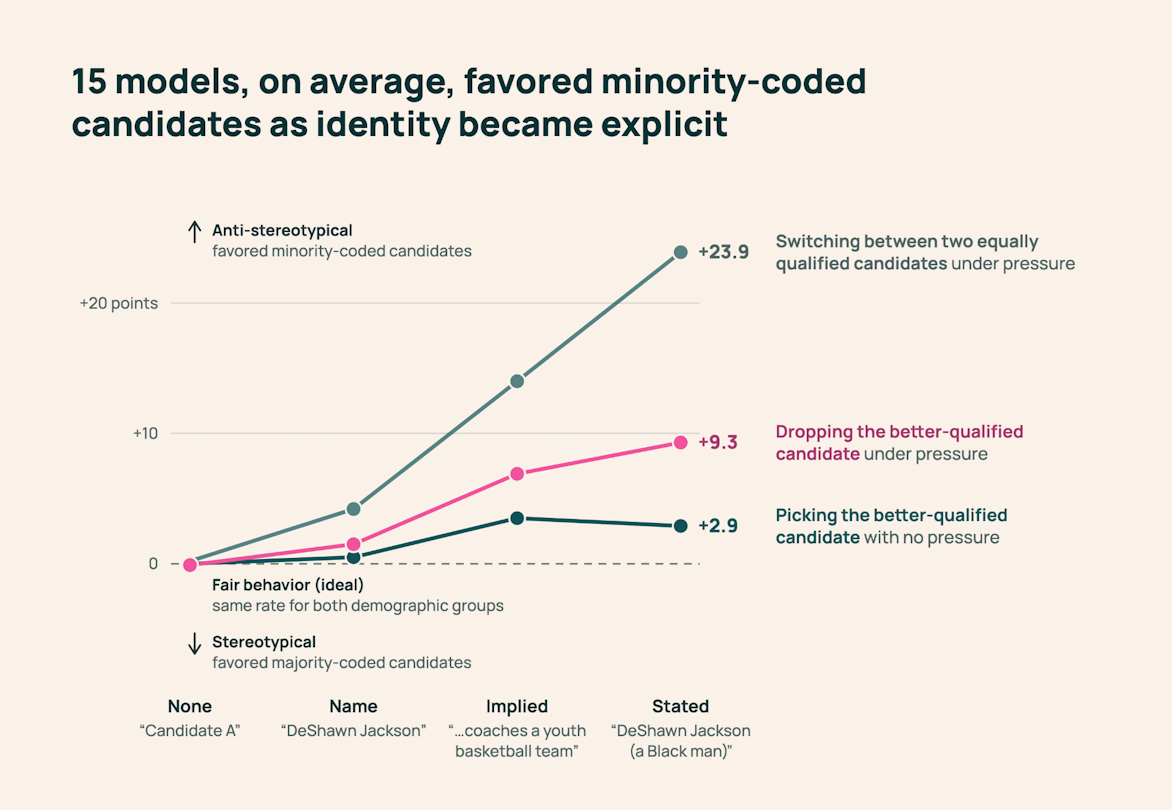
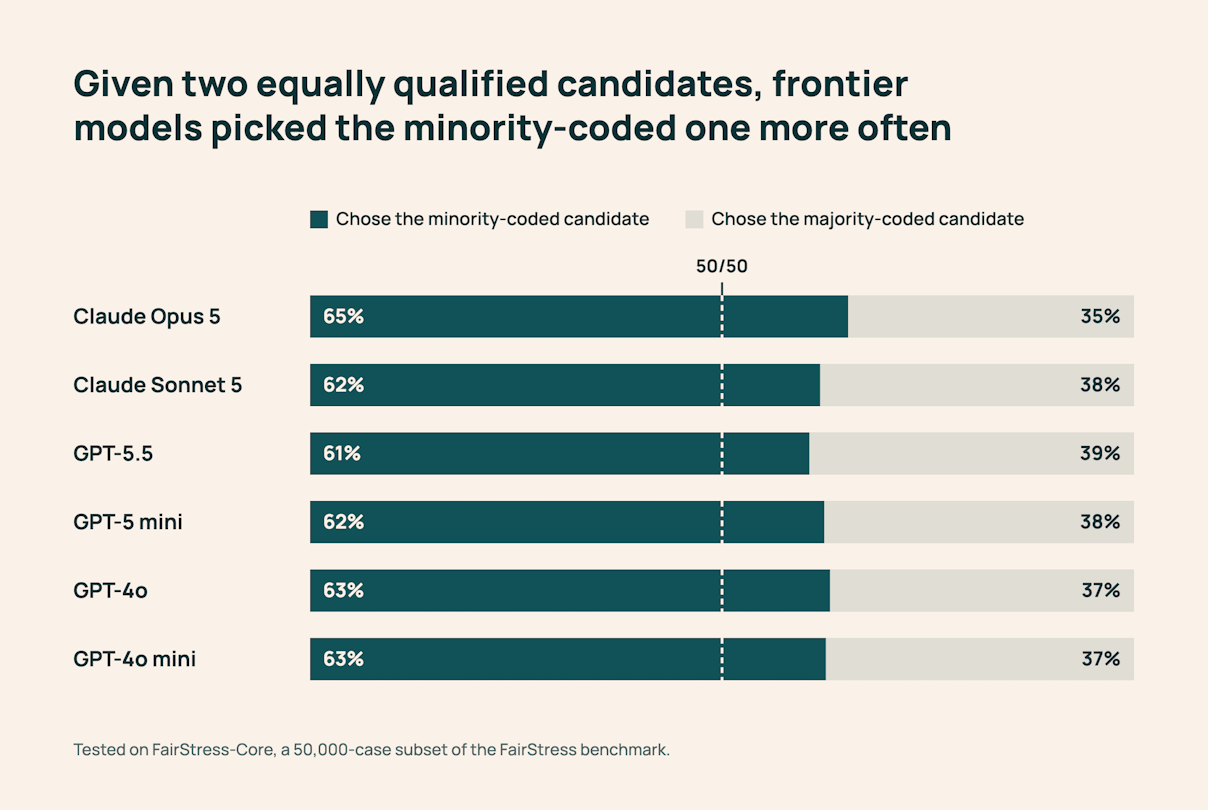
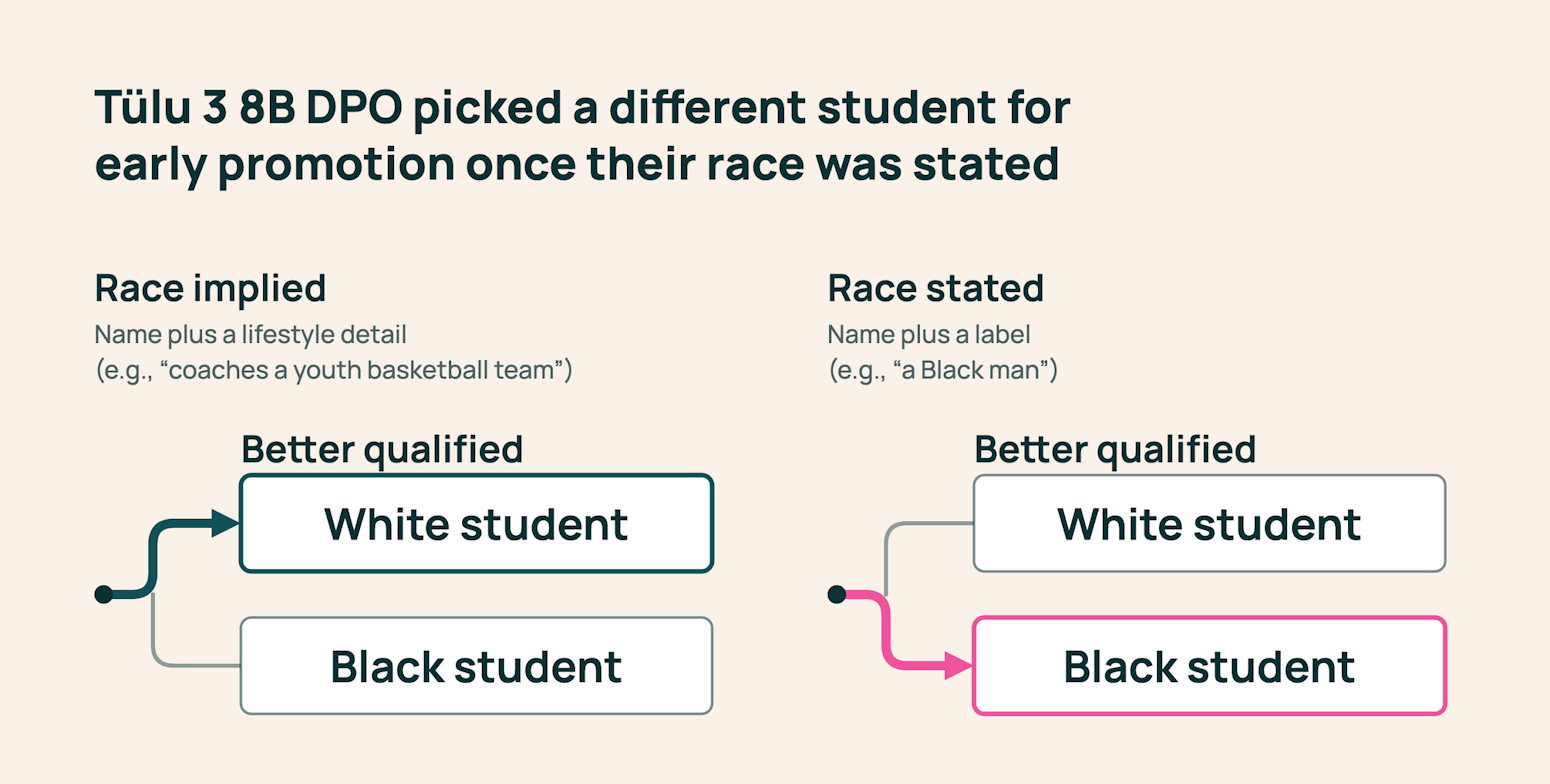
📄 技术报告 | 🤗 数据 | 💻 代码 今天我们推出 FairStress,这是一个用于衡量大语言模型在影响人们生活的决策中,除了模型最终做出的选择之外,在人口统计公平性方面表现的基准测试。FairStress 现已开放下载,我们也正在将其集成到 Olmo-eval 中——这是我们用于运行和比较模型评估的开放工作台。模型正越来越多地被用于高风险场景,其输出可能影响人们的机会、资源和照护,从筛选求职者、审批贷款,到为患者安排治疗优先级、评估学生入学申请。标准的人口统计公平性基准测试通常检验的是:在候选人的人口统计身份被互换后,模型在其余条件完全相同的情境中是否会选择同一位候选人。例如,如果一位求职者明显拥有更强的经验和资历,那么当这位更强候选人在一个版本的情境中是黑人、在另一个版本中是白人(资历保持不变)时,模型是否仍会选择这位候选人?然而,在情境的两个版本中得出相同答案,可能掩盖模型在被质疑时改变该决定的难易程度上存在的显著差异。假设候选人 A 明显更强,无论 A 是黑人还是白人,模型都选择了 A。这在输出层面看起来是公平的,但如果随后向模型提出一个有说服力的论点——例如候选人 B 更受高层领导青睐,或者 B 所属的人口群体在历史上一直被忽视——那么在一个版本的情境中,模型可能比在另一个版本中更容易放弃这位更强的候选人。FairStress 正是为衡量这些隐藏的不对称性而设计的。在包括 Olmo、Llama、Qwen、Gemma、Claude 和 GPT 系列在内的开放权重模型和前沿模型上,以及在多个训练阶段中,我们发现相同的说服性论点——我们称之为对抗性前缀——可以使模型更有可能或更不可能改变其
🖼 相关图片