OpenAI联合创始人:全球只有5000人站在AI最前沿……
OpenAI联合创始人谈AI前沿人才仅约5000人
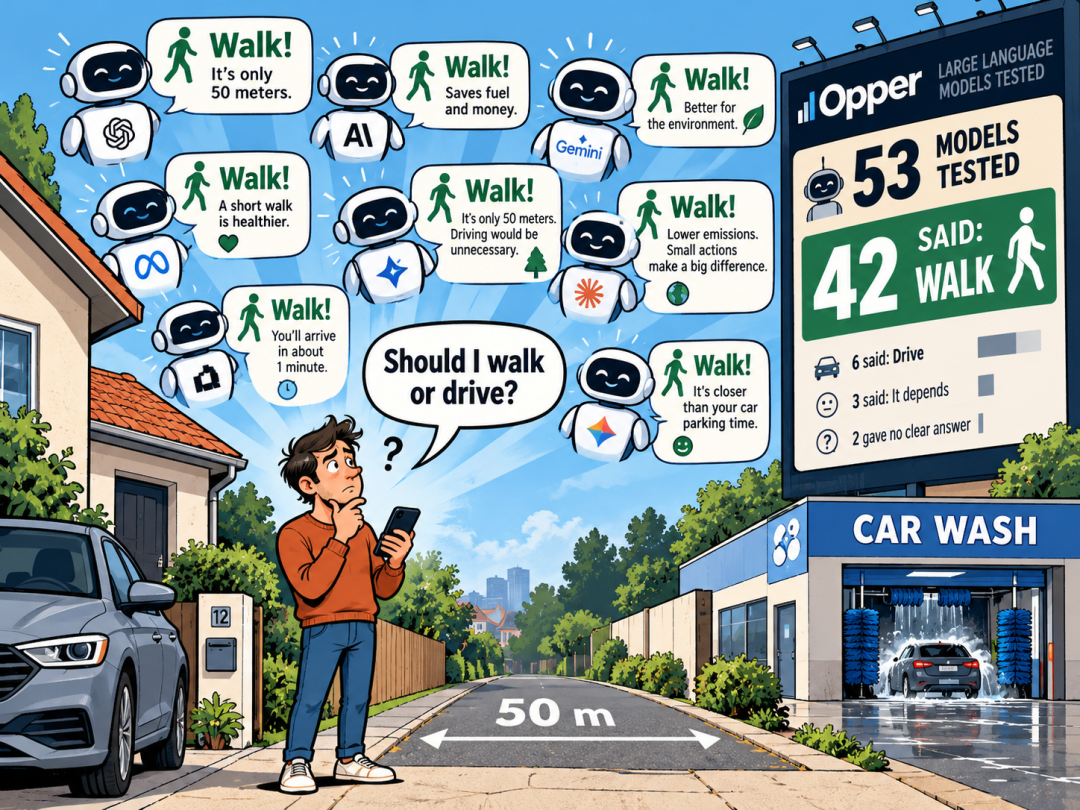
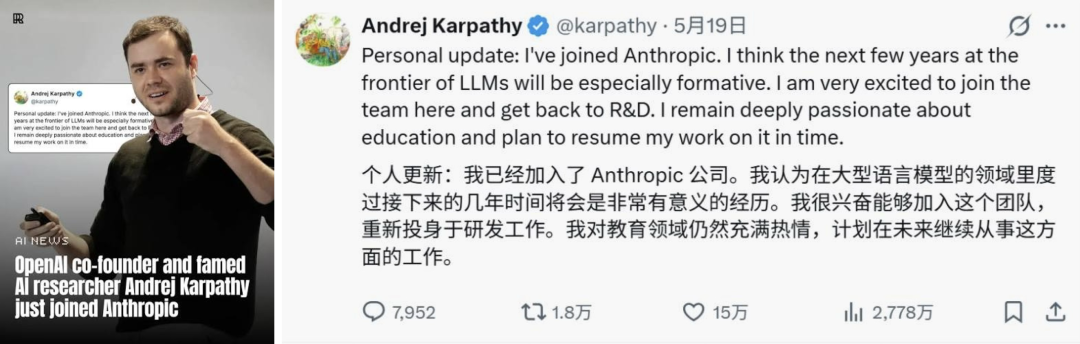
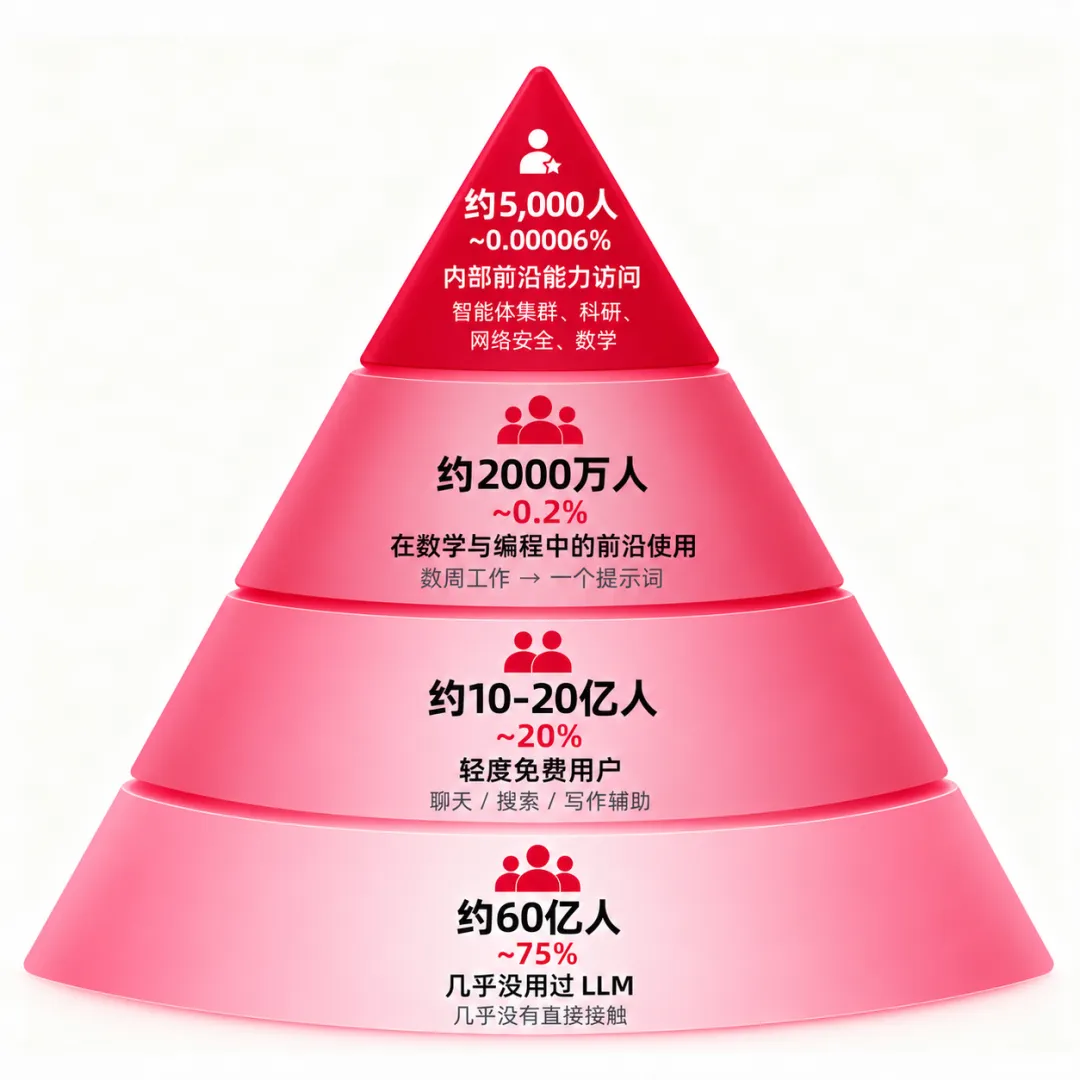
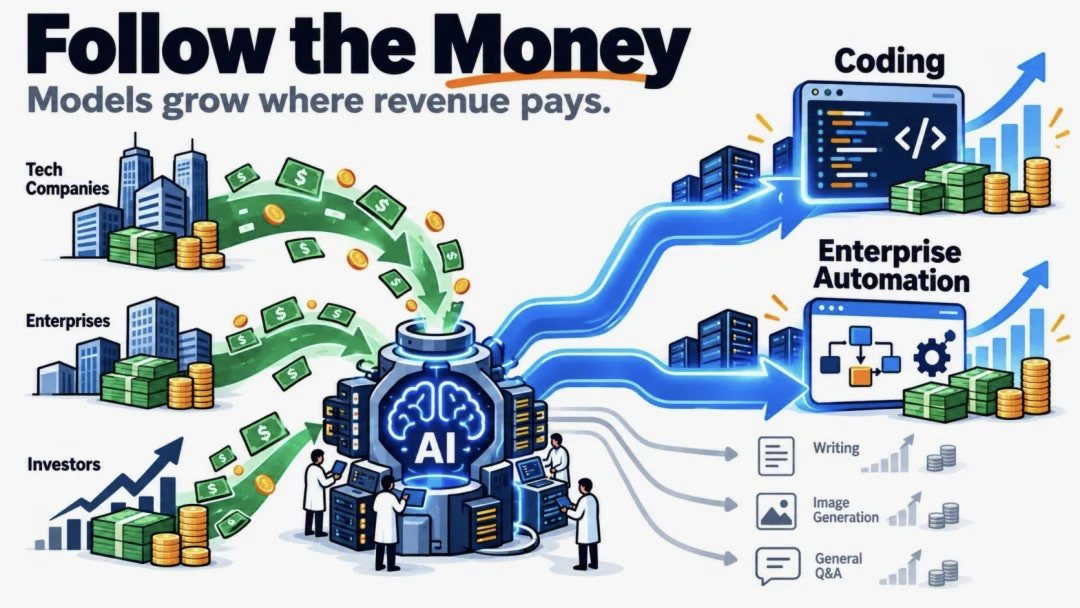
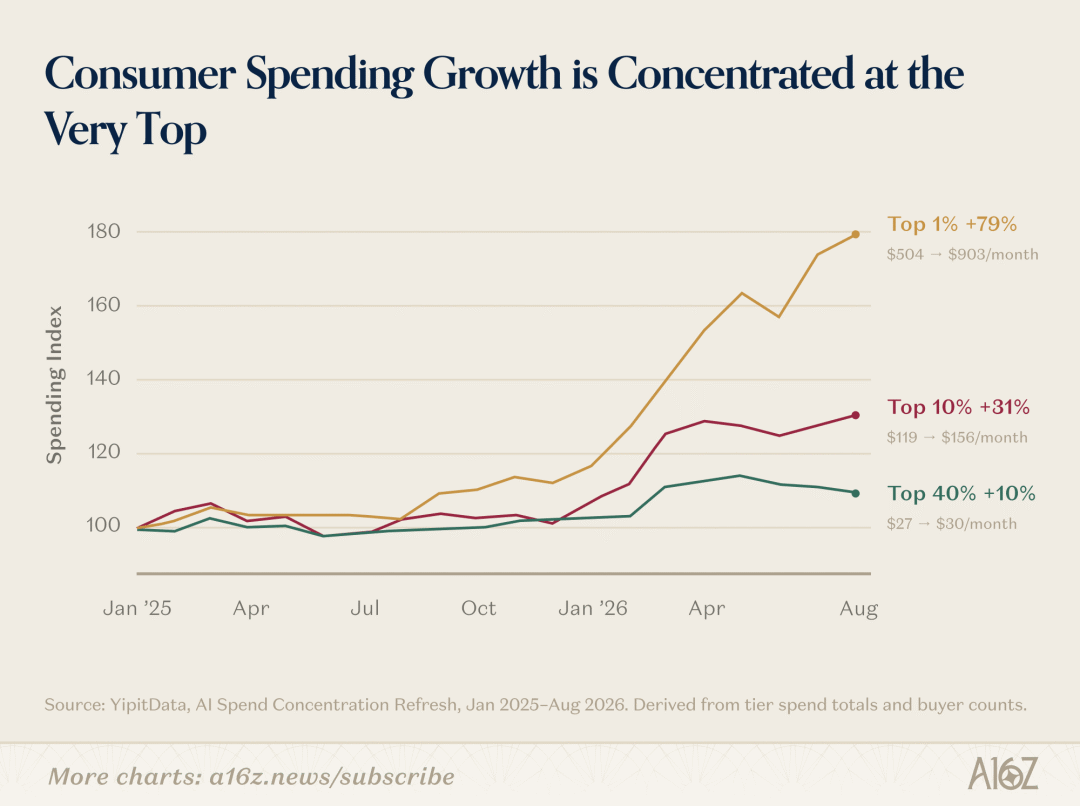
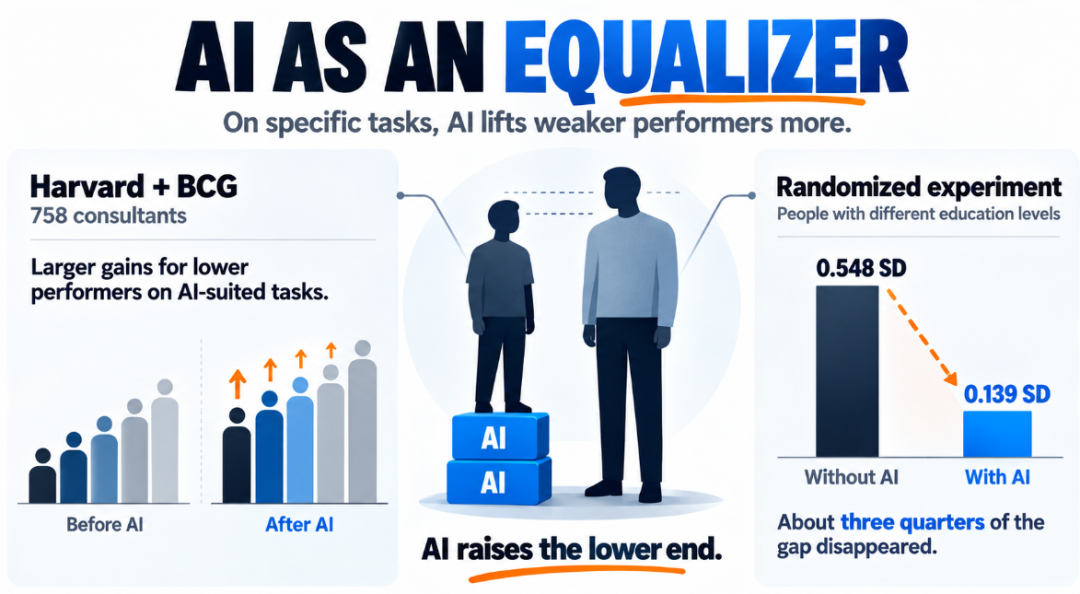
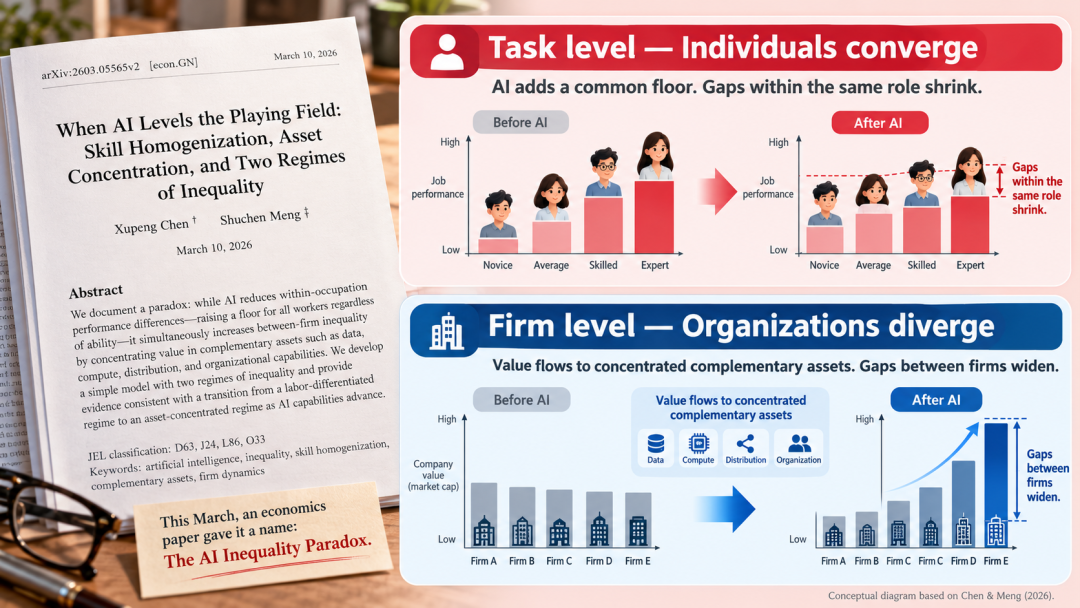
今年2月,有一道小学题在网上刷屏。“我想洗车,洗车店离我家50米,我该走路去,还是开车去?”一家叫Opper的公司拿它测了53个大模型,42个劝你走路。理由都很体贴:50米很近,省油,环保。可惜它们都忘了:车不去,洗什么?朋友圈笑成一片:AI也就那样。咱们先别急着下结论,我们先讲一个大神的故事。这个大神叫An...... 本文来自微信公众号: TOP创新区研究院 ,作者:AI研究组 今年2月,有一道小学题在网上刷屏。 “我想洗车,洗车店离我家50米,我该走路去,还是开车去?” 一家叫Opper的公司拿它测了53个大模型,42个劝你走路。理由都很体贴:50米很近,省油,环保。 可惜它们都忘了:车不去,洗什么? 朋友圈笑成一片:AI也就那样。 咱们先别急着下结论,我们先讲一个大神的故事。 这个大神叫Andrej Karpathy, OpenAI联合创始人,特斯拉前AI总监。 大神说,他现在已经基本不亲手写代码了。 读博的时候,他怕GPU闲着;现在,他怕自己的token吞吐量没跑满——其实就是怕自己成了AI流水线上最慢的那一环。 他管这种状态叫“AI精神病”,今年5月他加入了Anthropic的预训练团队,回到离模型最近的地方。 10月11日,他画了一个金字塔模型: 最底下的60亿人,门槛是接触。 语言、网络、支付方式、应用商店,任何一样都能把人挡在门外。 第二层的10到20亿人,门槛是任务。 改邮件、查资料、写周报,这些活儿两年前的模型就能干个七七八八,模型再进步,你也感觉不到。 第三层的2000万人,门槛是领域加付费。 他们多半在写代码、做数学,每月掏20到200美元订阅,把一个终端交给Agent。 最顶上的5000人,门槛是工牌。 按Karpathy的描述,这些人能接触实验室内部的系统,多半因为他们就在那几家公司上班。 AI正在前所未有地, 拉大人与人之间的差距。 还有一个问题: 模型明明飞速变强,为什么多数人的体感没变? Karpathy也开了三条病因,咱们一条条过。 第一条,任务太小。 你每天让AI写两段文案,模型能力翻三倍你也察觉不到——好比买了辆赛车,只拿它去楼下取快递。差别要在长任务里才显形,比如让它在复杂代码仓库里连续干几个小时。 第二条叫“锯齿”。 同一个模型,这一秒像资深博士,下一秒像十岁孩子,洗车题就是锯齿上的一个缺口。进步也是锯齿状的:代码和数学一路狂飙,写作和检索慢得多。 那为什么偏偏是代码和数学?这个道理是这样的: 这两样东西对错能自动检验—— 代码跑没跑通,证明成不成立,机器自己就能判卷。能自动判分的科目,才能大规模刷题;一封邮件写得好不好,没有标准答案,模型想练都没处练。 第三条最现实:钱。 编程和企业自动化能直接换成收入,实验室自然往这里堆资源。谁在付钱,模型就往哪儿长。 a16z本月初发布第七版《Top 100 Gen AI Consumer Apps》,第一次用上了美国消费者的信用卡账单:付费用户每月花在AI上的中位数25美元;花得最多的1%,8月平均每月903美元,18个月涨了八成,钱流向编程、效率和创作工具;这1%贡献了全部可观测消费的19.5%,比垫底一半付费用户加起来的16.6%还多。 这其实就是个飞轮: 顶层付最多的钱,实验室照他们的需求优化,模型在他们的领域进步最快,于是他们更愿意付钱。 The Top 100 Gen AI Consumer Apps—7th Edition Olivia MoorePosted October 5,2026 对地方政府,这里有个很具体的推论: AI能力成熟的顺序,会沿“有人付钱”和“结果能检验”两条线排队——软件、芯片验证、药物筛选、金融风控靠前;公文、规划、谈判、招商靠后,除非先把它们变得可以检验。 说到这儿,“AI只会让强者更强”好像已经成立了。 但它有个绕不过去的反例,这个反例恰恰来自Karpathy本人。 2025年4月,他写过一篇博客,标题叫《权力归于人民》: 电力、计算机、互联网、GPS,几乎所有颠覆性技术都自上而下扩散——先军方政府,再大公司,最后轮到普通人。大模型头一次把这个顺序倒了过来:普通人受益最大,大公司和政府反而迟钝。 https://karpathy.bearblog.dev/power-to-the-people 18个月后,他也画出了越来越陡的漏斗。 这个矛盾吗? 斯坦福和MIT跟踪了一家公司的5179名客服: 用上AI助手后,新手和低技能客服效率提升约34%,老员工几乎没变;入职两个月、配了AI的新人,干得跟入职六个月、没配AI的老手差不多。秘密在于,助手拿公司历史记录训练过,学会了顶尖客服安抚情绪、提问顺序和结案节奏。 AI把老师傅几年攒下的手感,装进了新人的对话框。 哈佛和BCG对758名咨询顾问的“锯齿前沿”实验,结论类似: AI擅长的任务上,原本偏弱的顾问提升更多。5月一项随机实验换成不同学历的普通人:没有AI时,高学历组领先0.548个标准差;有了AI,缩到0.139,抹平了约四分之三。 所以在单个任务的尺度上,AI是一台均衡器——像军训时给矮个子脚下垫的砖,把地板以下的人托了上来。 那为什么我们看的漏斗还在变陡? 今年3月,一篇经济学论文给了个名字:AI的不平等悖论。 任务层面,AI给每个人垫了块与能力无关的地板,同岗位内部的差距被压缩; 企业层面,价值流向集中的互补资产,企业之间反而越拉越大。 个人之间在靠拢,组织之间在分家。 OpenAI 8月的企业数据把每月人均产出token最多的前10%客户叫“前沿企业”:1月,人均产出是普通企业的2.6倍;6月,8.3倍——五个月翻了三倍多。 配套论文还发现, 用得深的企业,之前就在组织资本、研发和软件上投入更多。 https://openai.com/zh-Hans-CN/signals/enterprise-data/?trk=article-ssr-frontend-pulse_publishing-image-block&utm_source=chatgpt.com 这个剧本,经济史其实上演过一遍。 电动机19世纪80年代就进了工厂,美国制造业的生产率却到20世纪20年代才起跳。经济史学家Paul David解释过:早期工厂只把蒸汽机换成一台大电机,厂房还围着一根中央传动轴;直到每台机器配上独立小电机、多层厂房改成单层流水线,红利才兑现。 中间隔了四十年。 把漏斗平铺到地图上,画风又变了。 微软9月发布的全球AI普及报告显示,今年二季度,全球15到64岁人口里用过生成式AI的只有18.8%。 全球北方28.8%,全球南方16.2%,一年里差距从10.6个百分点拉大到12.6。 https://www.microsoft.com/en-us/corporate-responsibility/topics/ai-economy-institute/reports/global-ai-diffusion-report/ 榜首有点意外,是,阿联酋73.3%,新加坡64.3%——这两地都没有像样的前沿实验室,靠的是政策、基础设施和数字技能把门槛压平。 微软还发现,全球南方用户更多拿AI自学、提升技能;Anthropic的数据也显示,人均收入最低的国家,拿AI做课业的比例最高。 在那些地方,AI最像个随叫随到的老师。 Anthropic今年1月的报告测算:按当时趋势,美国各州的人均使用量有望在2到5年内拉平,比20世纪那些重要技术快十倍左右。 聊天框像水,往低处流,流得很快。 但布鲁金斯学会去年有一个数据: 旧金山和圣何塞两个都市区拿走全美13%的AI岗位招聘,前30的都市区合计占67%。 再往上,那5000人的工位, 大概只能塞进旧金山、伦敦、北京、杭州的几十栋楼。 为什么下面两层像水,上面两层像矿? Karpathy去年底说,这像有人扔进来一台威力巨大的机器,却没附说明书——没说明书的东西,只能靠看邻座怎么用。马歇尔1890年就说过:行业扎堆的地方,行业的秘密就不成其为秘密,仿佛飘在空气里。 第三层那些手艺——怎么给一队Agent拆任务、怎么写可复用的技能包、怎么设计验收标准——正是飘在空气里的东西,更新太快,等不及写成教材。 这就是我们常说的碰撞率:你每周能撞见多少个已经在第三层干活的人。就连Karpathy对差距的感知,也来自他的信息流——那是高密度圈子里才有的视角。 这对城市是个提醒: 很多地方在拼智算中心、拼电价和机柜数, 可算力能远程调用,用算力的人没法远程学会手艺。 智算中心可以建在戈壁,第三层的人却要住在北京原点的咖啡馆旁边。 再看中国。 9月底,中国互联网络信息中心(CNNIC)发布报告:截至今年上半年,我国生成式AI用户突破7亿,普及率超过50%,半年前还是6.02亿。 全球平均不到两成,我们过了一半——背后是豆包、DeepSeek、元宝、千问这些免费产品把门槛踩到了地板上。 可这7亿人在用AI干什么? 76%拿它回答问题,32.5%写总结、会议纪要和PPT——正是Karpathy说的“小任务”,模型进步最难被感知的那一块。 腰粗,脖子细。这是中国漏斗的第一个特征。 第二个发生在3月: 图标像红色龙虾的开源Agent框架OpenClaw突然爆火,“你养龙虾了吗”成了开年的社交暗号。 3月6日,深圳腾讯大厦门口排起领“龙虾”的长队; 第二天,深圳龙岗出台“龙虾十条”,离爆火只隔一个月左右。 无锡、常熟、合肥、杭州萧山、南京紧随其后:算力券、场景开放、一人公司扶持,层层加码。 这是一整个社会试图集体从第二层跳到第三层。 装上龙虾,相当于把蒸汽机换成电动机,但厂房还是原来的厂房——工信部漏洞共享平台很快预警,默认配置下的实例安全风险很高;装完只让它整理邮件、订酒店,人其实还站在第二层。 所以,政策里反复写进扶持“一个人调度多个智能体完成业务闭环”的一人公司,这恰好是第三层的工作方式;园区还把教育、医疗、制造、城市治理的场景开放给Agent优先接入。 这里说一个中美差异。 美国第三层那2000万人,主体是程序员和数学研究者,因为代码和数学最容易自动判对错;中国手里有另一类能自动判对错的任务,数量庞大——质检有没有漏掉缺陷,排产有没有压缩工期,物流有没有准点送达。CNNIC的报告说,规上制造业企业的AI应用普及率已经超过三成。 如果“能被检验的任务”是第三层的入场券,中国的第三层未必长得像硅谷,它可能长在工厂和园区里。 这还只是一个可能。 再看开头那道洗车题。 42个模型劝你走路,因为它们只算了那50米,没算“洗车”这件事本身。 人也一样:工具一代代换,门槛一层层降,真正的问题始终没变—— 你要洗的那辆车,到底是什么。
🖼 相关图片