VibeVoice-ASR-BitNet 实测:AIGCPanel 上 CPU 实时转写
微软VibeVoice-ASR-BitNet压缩至1.58GB,CPU实时转写
微软把语音识别模型从 4.62GB 压到 1.58GB,AIGCPanel 把它做成了一键运行包。
过去想在本地跑出能用的中文转写,常见路径要么上显卡,要么花半天折腾 Python 和 CUDA。纯 CPU 的方案不是没有,但大多在速度和准确率之间做过妥协。VibeVoice-ASR-BitNet 是微软开源的另一个答案:模型 1.58GB,纯 CPU 推理,支持中英法意韩葡越等语言。
本地转写卡住的往往不是模型本身,是把它送到普通人桌面上的那几步。
先把「实时」说清楚: 这里指 RTF 小于 1,也就是转写速度快过音频时长。它是上传文件后转写,不是麦克风边说边出字。
测试机是一台 Ryzen AI 9 HX 370 笔记本(12 核 24 线程、59GB 内存、Linux)。音频是把同一段贷后话术重复五遍合成的 31 秒 wav,下表耗时不含转码和模型加载。
| 线程数 | 识别耗时 | RTF |
| — | — | — |
| 2 | 28.1 秒 | 0.90 |
| 4 | 20.1 秒 | 0.64 |
| 8 | 14.5 秒 | 0.46 |
RTF 0.64 的意思是,31 秒的录音 20 秒转完,这台机器没有独显。线程从 4 加到 8 只快了 28%,日常给 4 个线程就够。
微软模型卡里的参考数字量级差不多: 20 秒音频、AMD EPYC 机器,3 线程 RTF 0.77,4 线程 0.63。官方说比 Whisper.cpp 快 1.6 到 2.3 倍。
这段音频是合成语音,不适合拿来评估准确率,识别质量看后面的模型卡数据。
运行包的要求写着 8G 内存、无需 GPU。8G 是下限,不是爽点:老一点的轻薄本会更慢,建议先拿一分钟音频试。CPU 需要有 AVX2。
压掉的这 3GB,换来的是一台没有独显的笔记本也能干活。
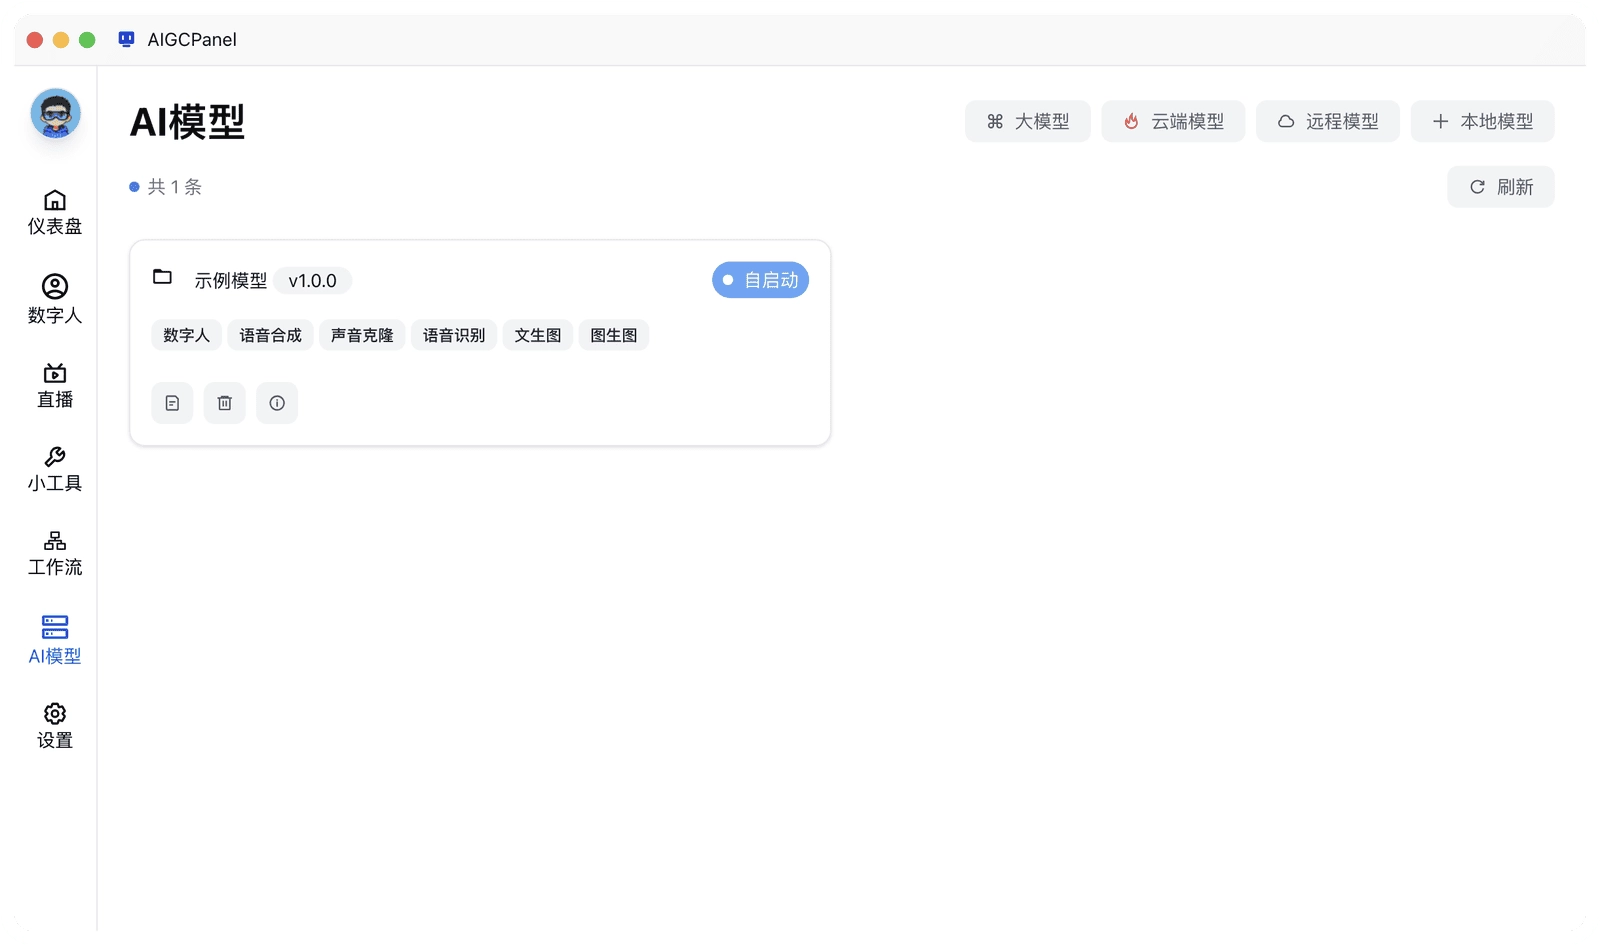
AIGCPanel 是一站式 AI 数字人桌面应用,官网模型市场里放着一批一键运行包。VibeVoice-ASR-BitNet 这一款标着免费、内存 8G+、语音识别,提供 Windows x64 和 Linux x64 两个版本。下载解压,在「AI 模型」里添加成本地模型,点启动就能用,不用配 CUDA,也不用建 conda 环境。
包里是预编译好的 asr_infer 推理引擎,按平台分目录存放,启动时直接调用,不依赖系统里的 Python 包。模型权重是两个 gguf 文件,670MiB 加 947MiB;启动时核对大小和 sha256,缺文件或校验不过,就按 ModelScope、hf-mirror、HuggingFace 的顺序补下,支持断点续传。整个过程不出本机。
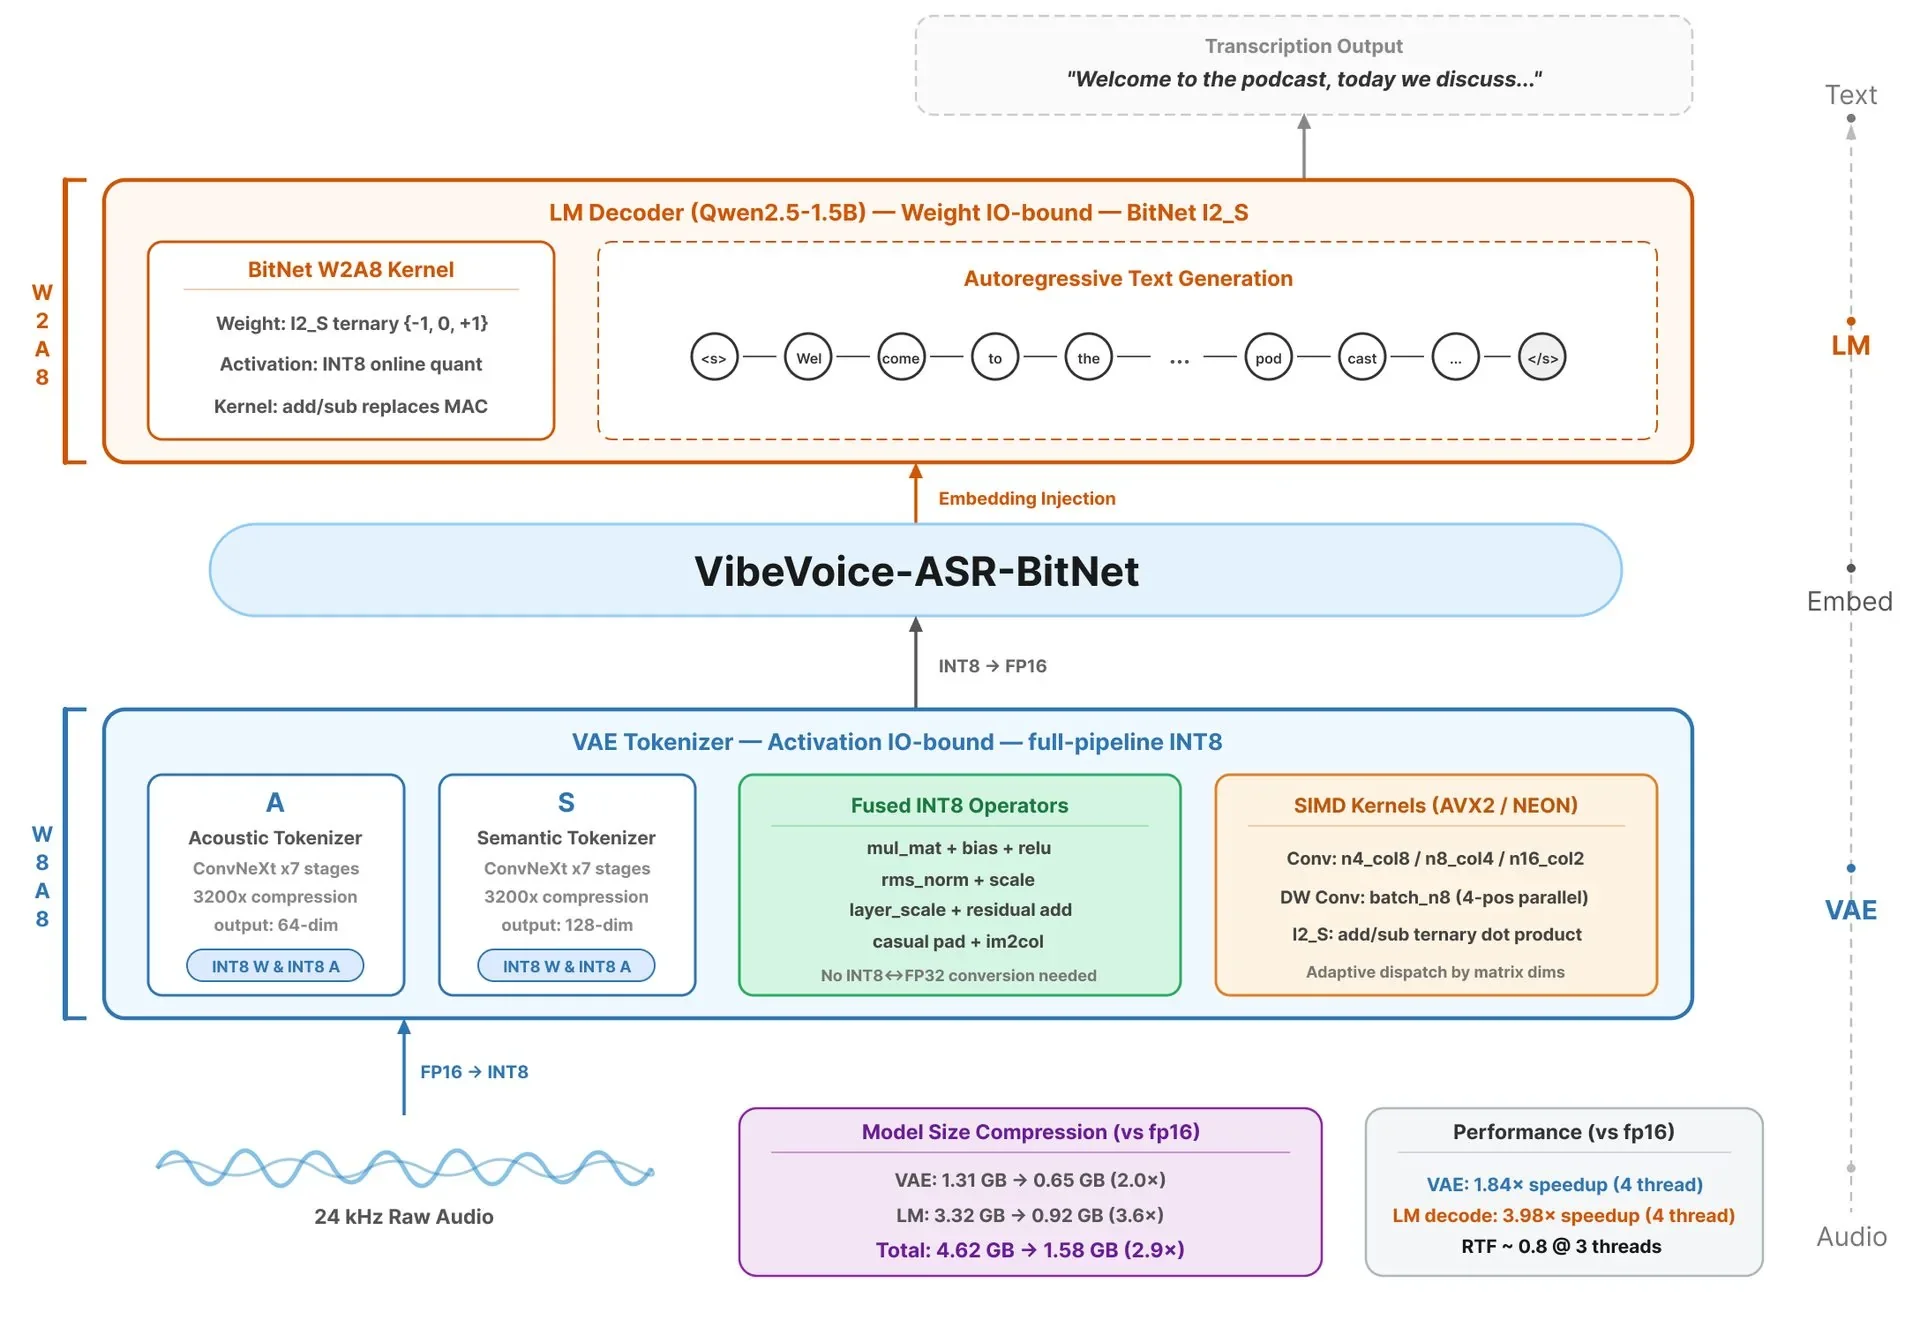
能跑在 CPU 上,关键在压缩方式。微软没有用一套量化打天下,而是给两个组件分别挑了方法。
VAE 分词器负责把音频变成特征,用 8 位整数就够,从 1.31GB 降到 0.65GB。LM 解码器是权重大户,用 I2_S 三值权重(只有 -1、0、+1)加 Q6_K 嵌入,从 3.32GB 降到 0.92GB。三值权重把矩阵乘法换成加减法,这是 BitNet 省算力的根子。再配上针对 AVX2 和 NEON 手写的 SIMD 内核、在 ggml 里做算子融合,三五个线程就能跑出实时速度。
代价在精度上。模型卡里,单语种朗读类基准的 WER 比 7B 原版高 0.2 到 2.5 个百分点,英语 MLC 是 7.82 到 8.25;会议场景高 1.7 到 4.4 个点;中文 AISHELL4 差距最大,19.83 到 27.45。
值不值看用途: 做字幕初稿、会议纪要、素材检索,这个水平够用;结果要直接对外发布,还是得人工过一遍。
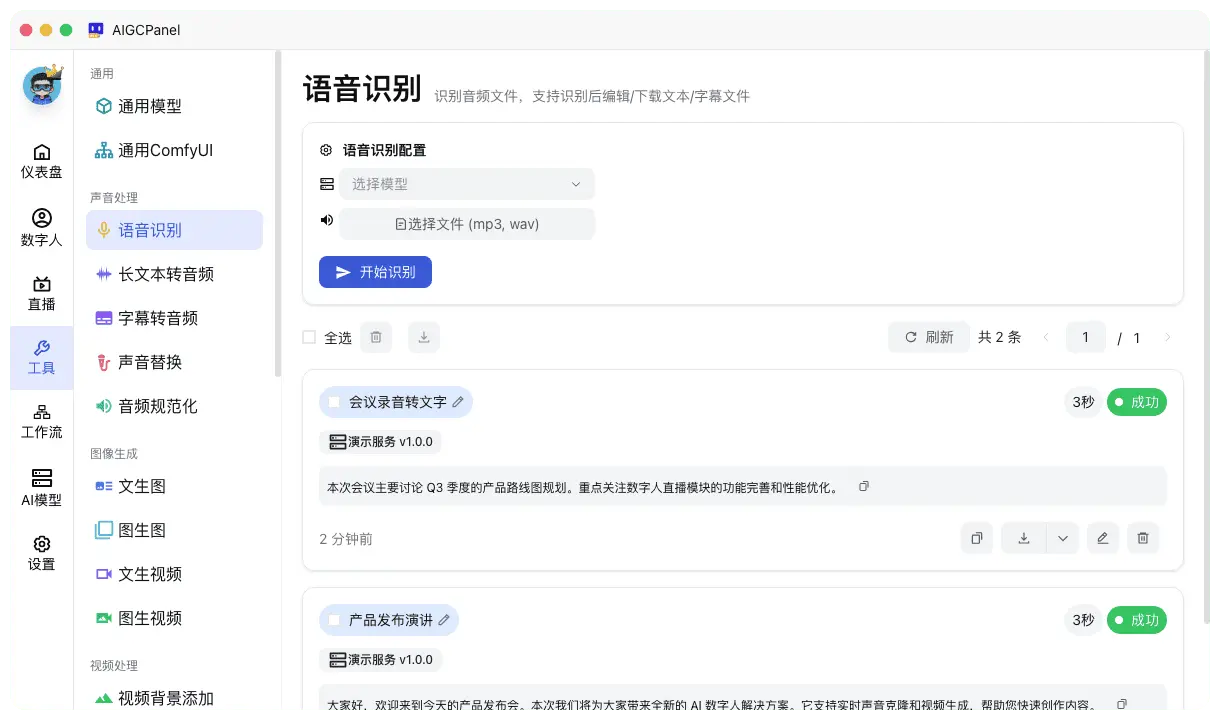
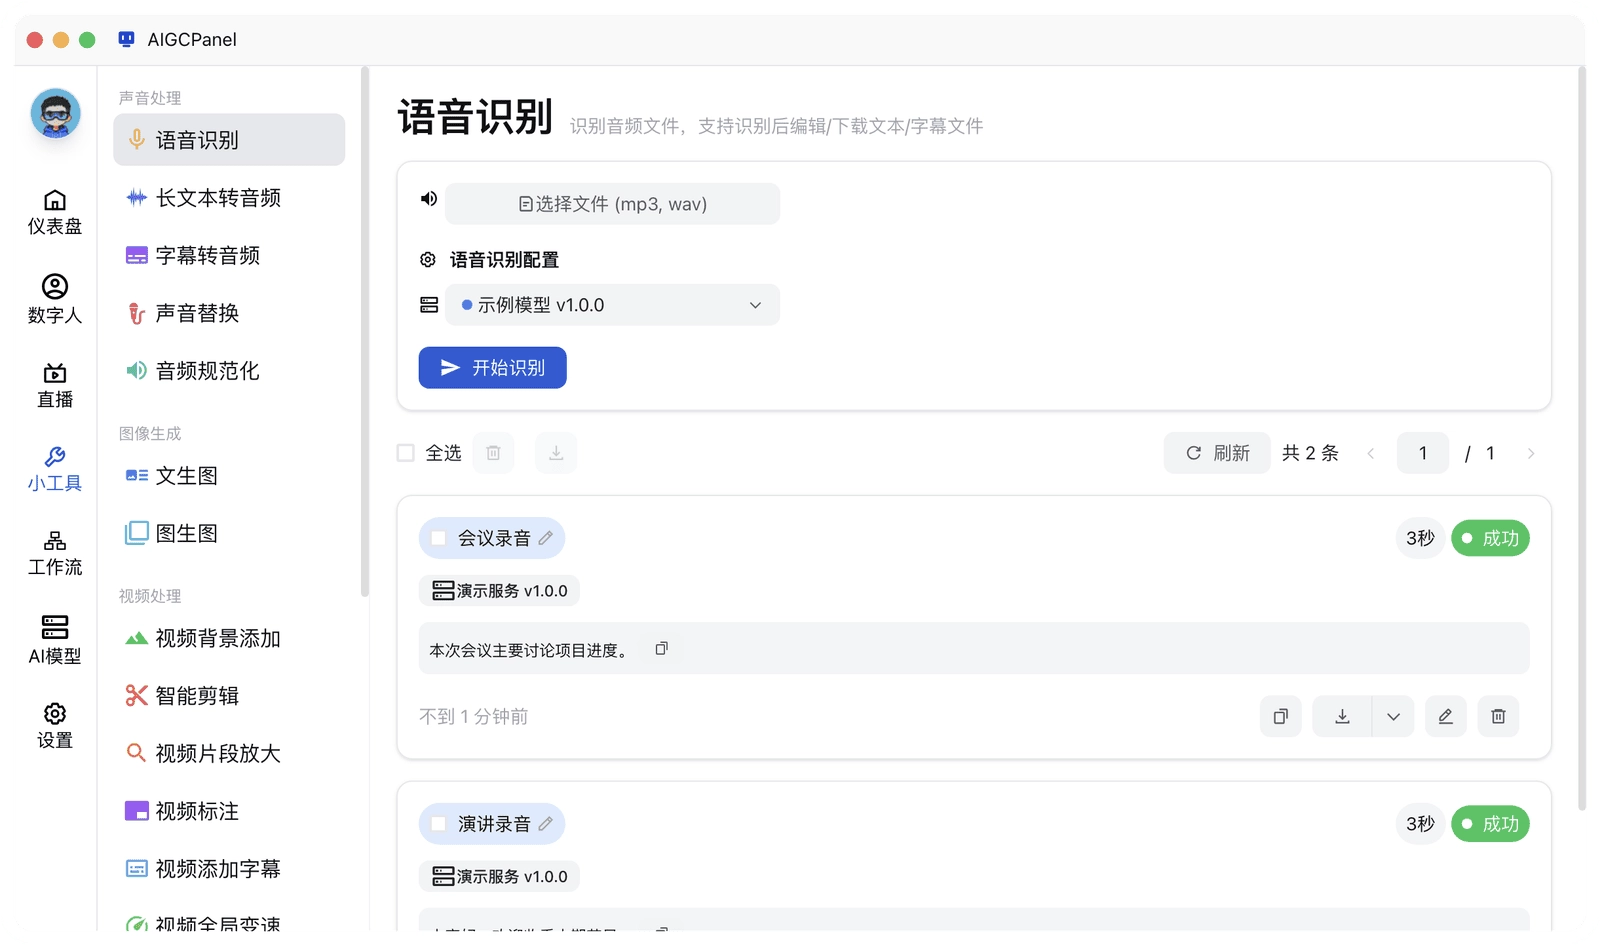
AIGCPanel 的语音识别工具把结果按分段整理成 start / end / text,引擎输出带时间戳的片段时会保留起止时间。识别完能在界面里改错字,改完导出文本或字幕文件。
参数只暴露两个。线程数 1 到 16 可调,四线程一般是甜点,别一上来拉满。另一个是热词/上下文,填几个专有名词、人名、产品名,垂直领域的识别会稳一些。音频送进引擎前自动转成 24kHz 单声道 wav,mp3 直接丢进去就行。
单人播客、口播视频、课程录音、近场访谈的转写,是它最舒服的场景。离线可用,音频不出本机,对隐私敏感的内容尤其合适。
多人会议和客服通话要谨慎。模型卡里 AMI、AliMeeting 这类多人重叠、远场录音的 WER 在 20% 到 40%,当前界面也只输出文本和时间,不做说话人区分。
如果你要的是极致准确率,或者音频里方言口音很重,未量化的 7B 原版和更大的模型仍然更稳。这个包解决的是另一件事:让没有显卡的机器也能转写。
参考资料: 模型卡、VibeASR.cpp、AIGCPanel 模型市场。测试机型与数据由我们自己测得,运行包由 AIGCPanel 团队适配。
模型卡标注 MIT,打包的引擎和依赖的许可证另需确认
官方运行包目前只有 Windows x64 和 Linux x64,macOS 还没上架
模型权重约 1.6GB,磁盘最好留出 3 到 4GB
需要 AVX2,ARM Linux 和 Windows ARM 没验证过
没有流式接口,不能边录边转
如果你手边正好堆着几段没整理的录音,值得花十几分钟装上试试。试完回来聊聊:你转的第一段音频,错了几个词?
本地语音识别的门槛,已经从「有没有显卡」变成了「愿不愿意点一次下载」。
🖼 相关图片