拿注意力层当内存——有人在 Qwen 权重里编译了一颗 RISC-V CPU
开发者将RISC-V CPU编译进Qwen权重并用作内存
开发者 Divyansh Agrawal 往 Qwen 3.5 4B 的权重里编译了一颗真正的 RISC-V CPU,然后用模型自己的 Gated DeltaNet 注意力层当内存。他给这东西起名 Qwenputer。
先把话说明白:这不是插件、不是工具调用、也不是沙箱。CPU 完全跑在模型的前向传播里,能执行算术、跑 C 和 MicroPython 代码,不需要任何外部运行时。
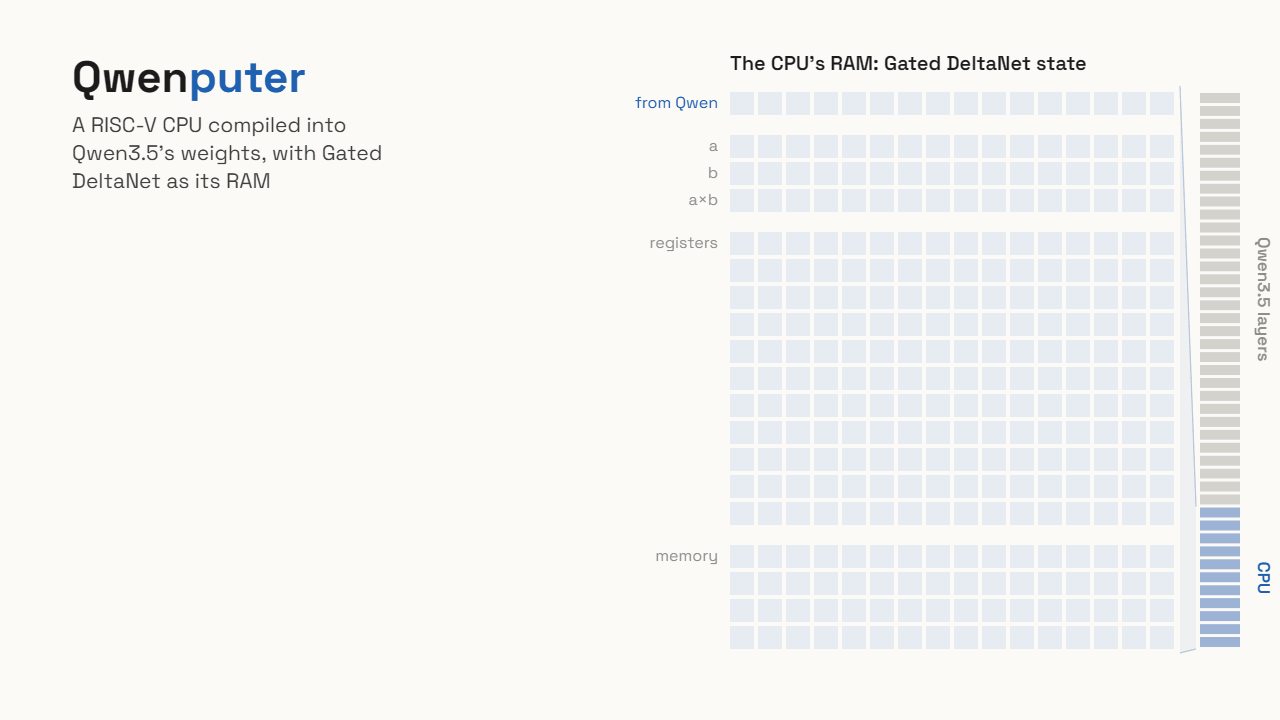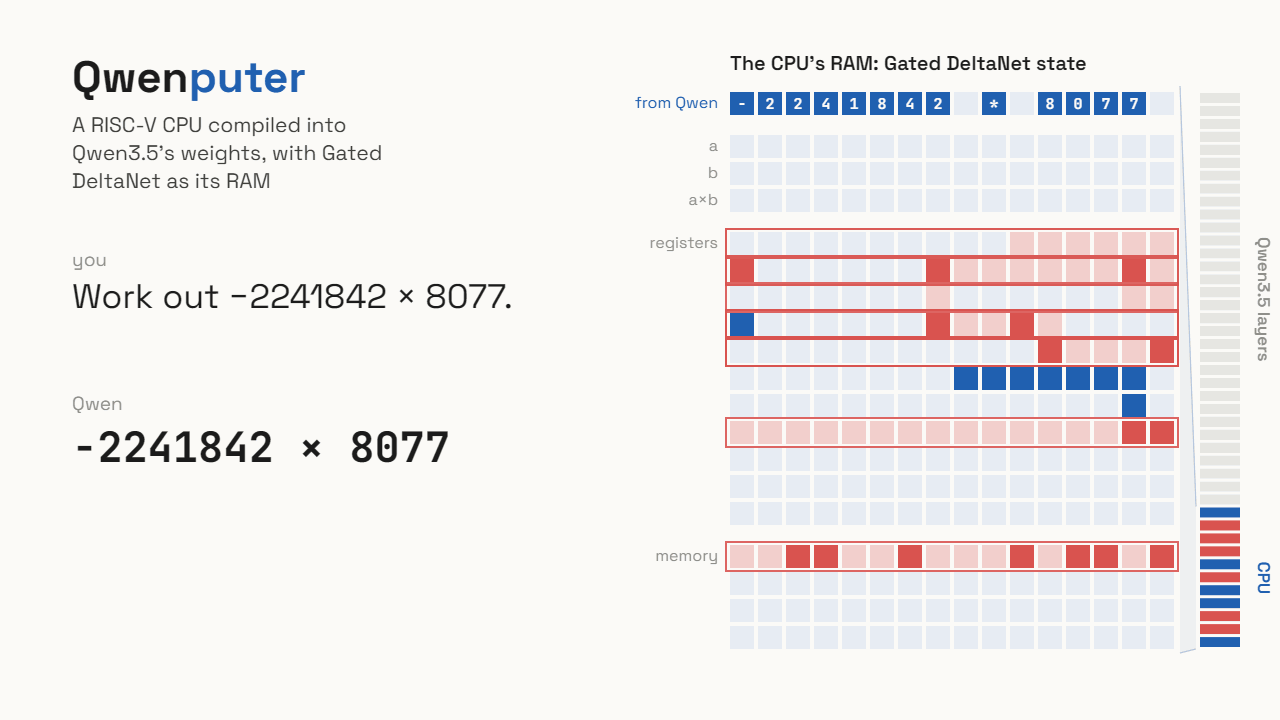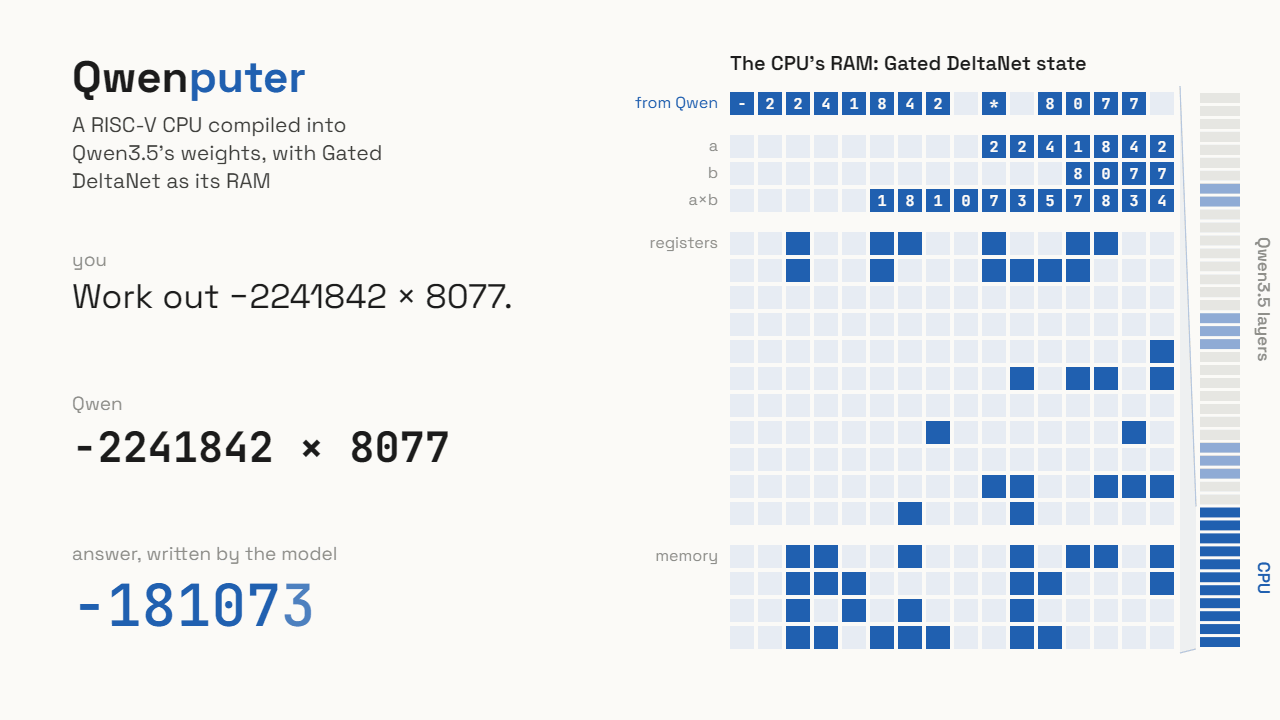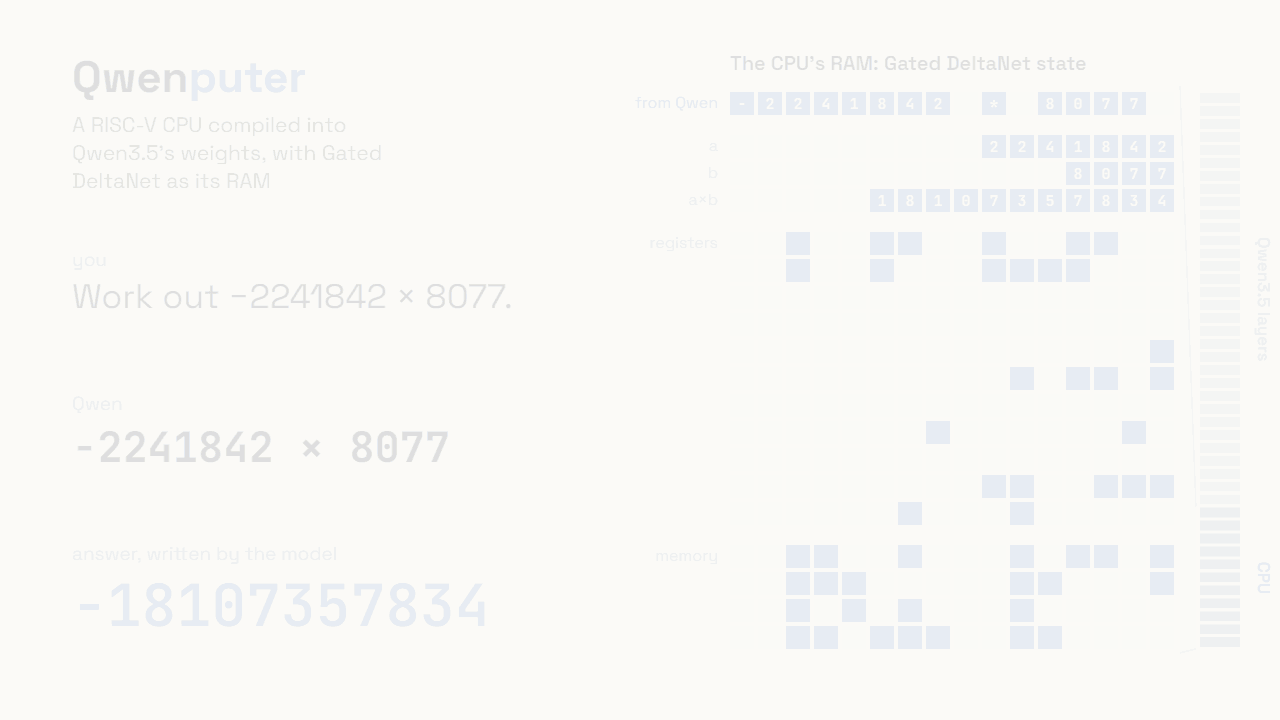
原理的第一半是"造内存"。Qwen3-Next 和 Qwen 3.5 里每 4 层注意力有 3 层用的是 Gated DeltaNet——一种线性 RNN,每个头维护一个状态矩阵。他发现把门控(gate)和写强度(beta)都设成 1,这个本来是"会遗忘的 RNN 记忆"就变成了精确、可寻址的 RAM。"delta 规则当内存用"这个想法不新,Schlag 等人在 2021 年就证明过线性注意力配 delta 规则等价于联想记忆(fast weights)。新的是把它做成精确的、可寻址的、能在一个生产级模型里稳定跑起整颗 CPU 的程度。
第二半是"造 CPU"。妙处在于不需要训练——编译器直接设定每一个权重。你把 CPU 描述成电路,一长串"读这个寄存器""把这两个数加起来""若为零则跳转"的小步骤,编译器把每一步翻成模型层的一部分。每条指令变成几个生成的 token:一个指定要写的内存行(ADDR),一个携带值(VAL),一个 STEP token 收尾。这些 token 就是 CPU 的执行轨迹——所以 Qwen 在生成它们的时候,CPU 是真的在跑。
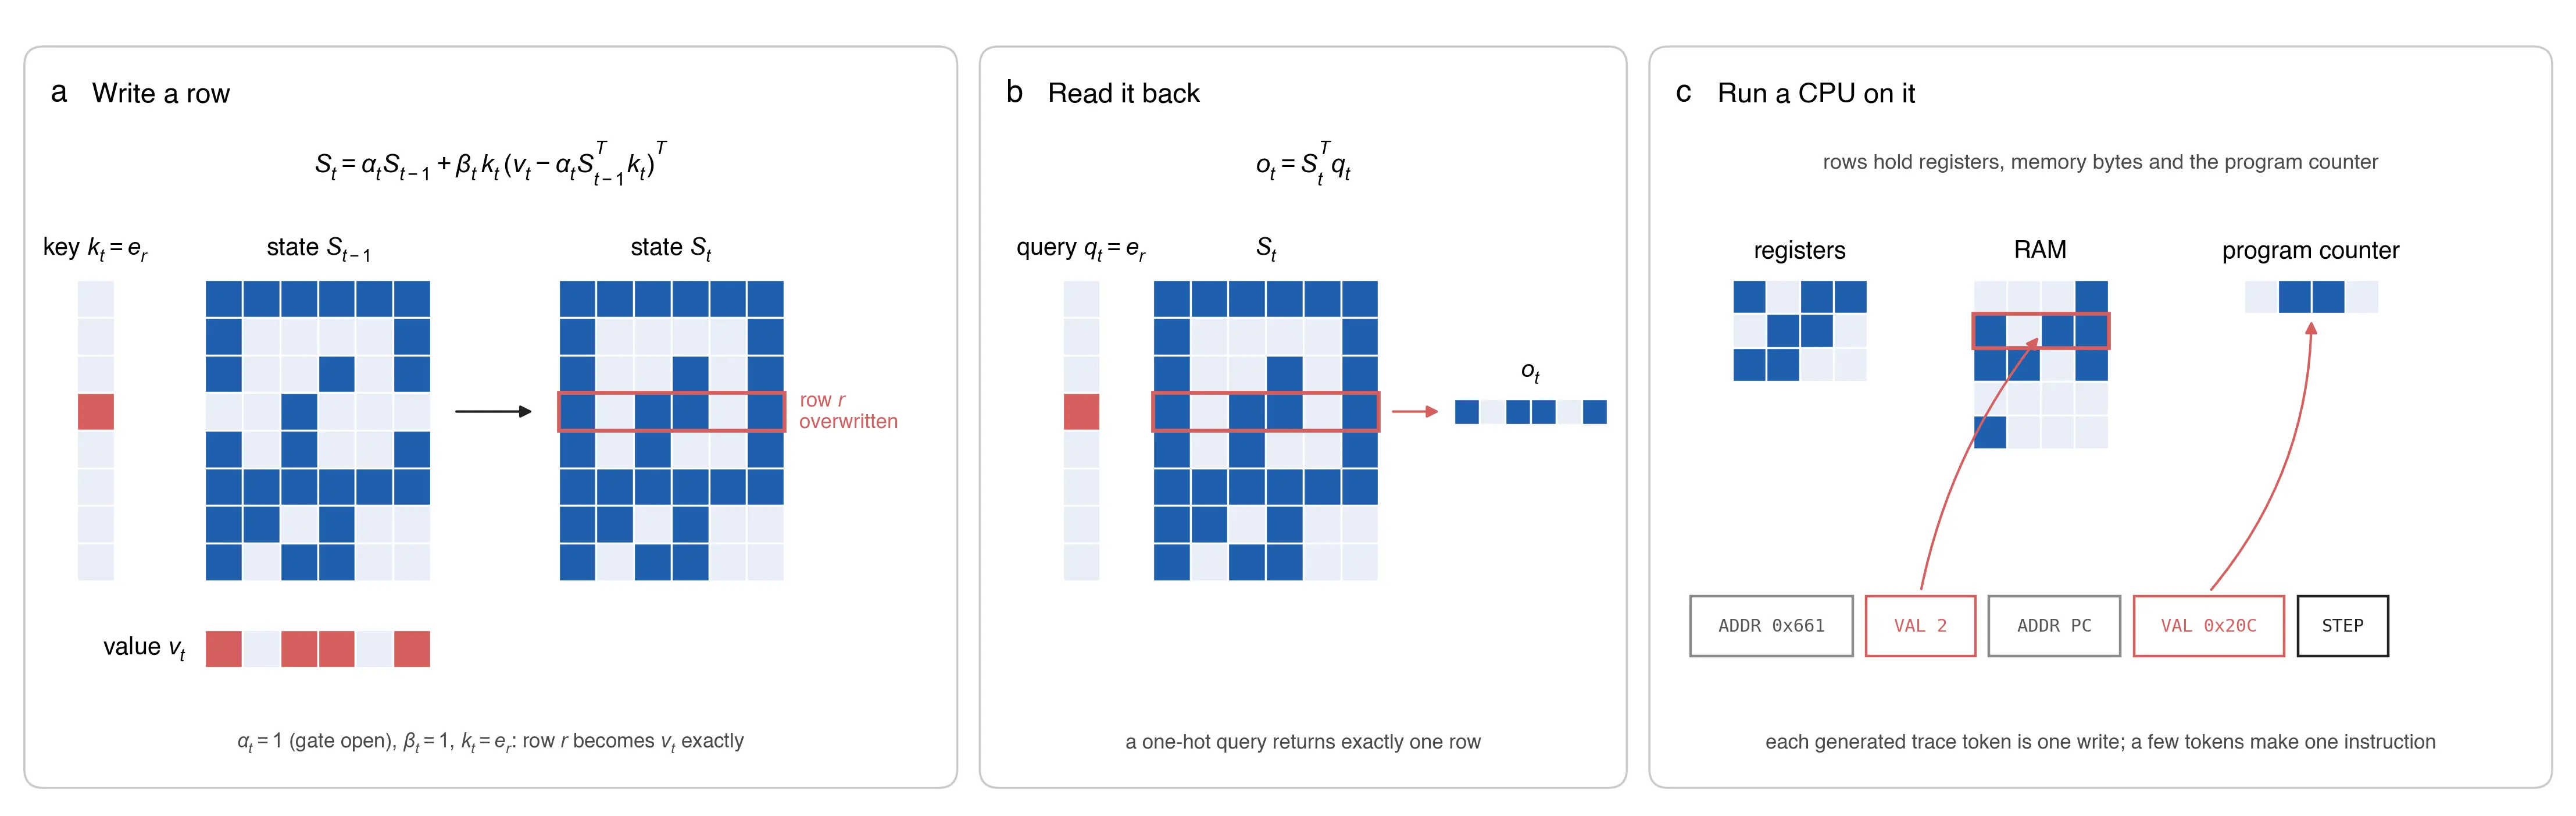
这颗 CPU 是 32 位 RISC-V 核(RV32IM 加 Zba 扩展和一个小型大数单元),占 Qwen 32 层里最前面 11 层。它通过了官方 riscv-tests,程序输出与 qemu 一致,还自主跑了 1800 万条指令零错误——"自主运行"是指整轮都靠自己的输出往前走,中途没有参考机纠正。
效果也验证了。在 NUPA 的长整数算术上,从 48.6% 直接到 100%,跟给 Qwen 一个 Python 工具一样。他把约 23 万个输出位置对照参考机重放,零不匹配。而且加了个计算机没改变 Qwen 说话的方式——正常文本输出跟原版 Qwen 的差异在噪声范围内(KL 6e-4,噪声底 5e-4)。
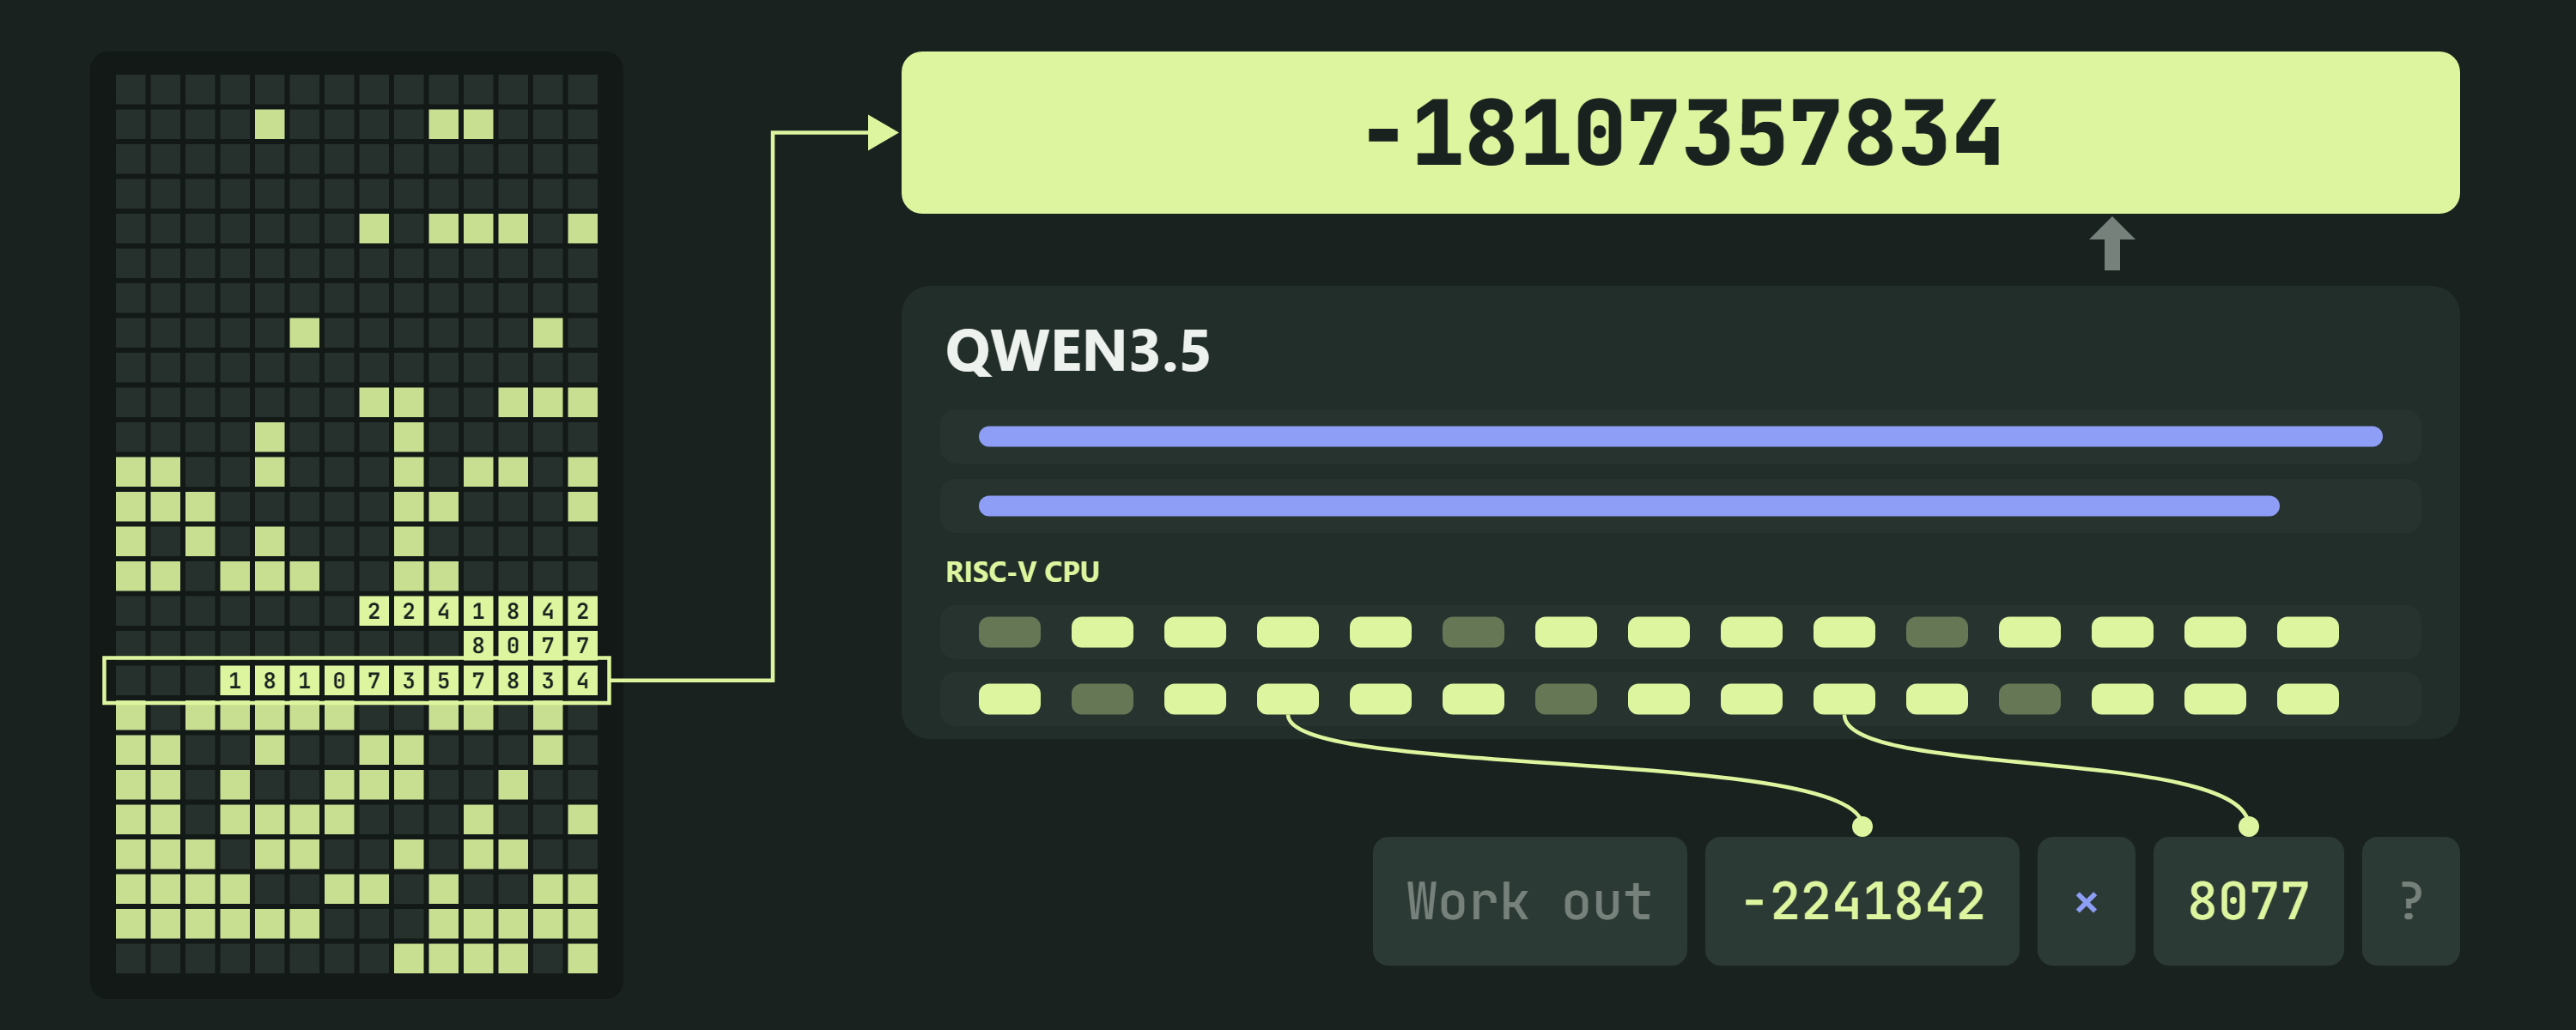
他甚至给这颗 CPU 配了个文件系统。原理上因为已经有可用的 RAM,这步"基本上很轻松":Qwen 保存文件时,编译好的层把文件名哈希到 DeltaNet 状态里 1024 个目录槽之一,正文存在其他头里,每行八个 token 链起来。持久性还不错——对话结束时存状态、下个对话载入,文件还在。用它记跨对话变化的事实,准确率 90%,而把旧对话粘回去只有 30%。
当然也有局限性:额外层和更宽的隐藏维度让 checkpoint 变成 18.8 GB,约为基础 Qwen 的两倍(虽然大部分是零填充);需要一个小驱动 RvChat 引导固件并把 trace token 挡在 Qwen 的层外,所以现在还不能直接 generate() 跑;速度偏慢,每条指令要几个解码 token,大计算按秒算而非毫秒。
他还顺手指出这条路对 AI 安全研究的意义——混合模型可以学着把推理藏进 RNN 状态里躲开思维链监控,而这类编译进权重的构造也能当模型自己关不掉的监控工具。
参考来源
🖼 相关图片