给AI写了一堆规则还在踩坑,终于有人从模型底层动刀了
MemOS团队从模型底层改进Agent记忆机制
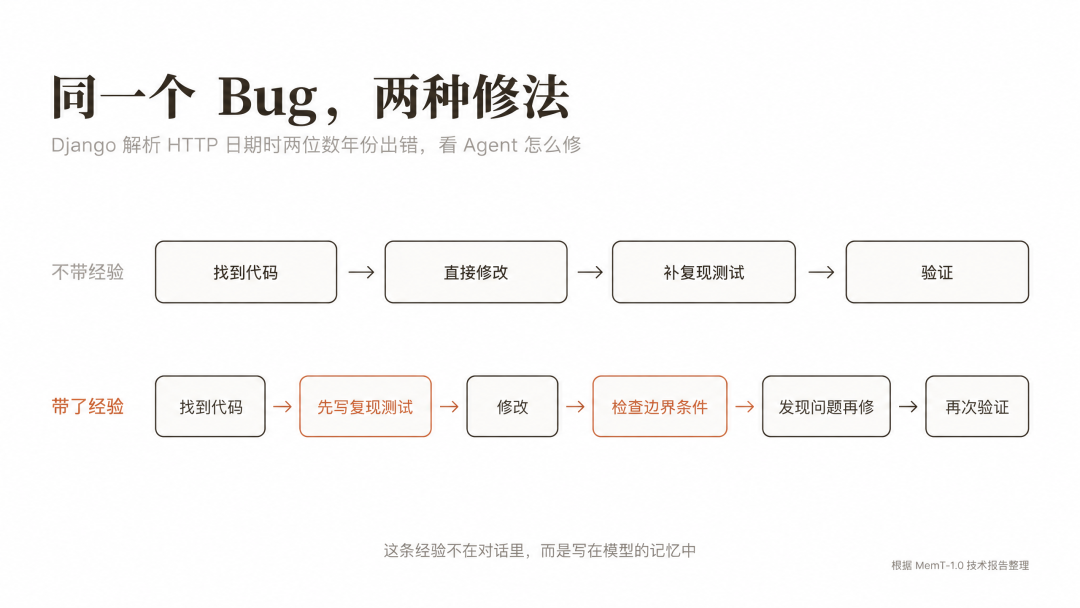
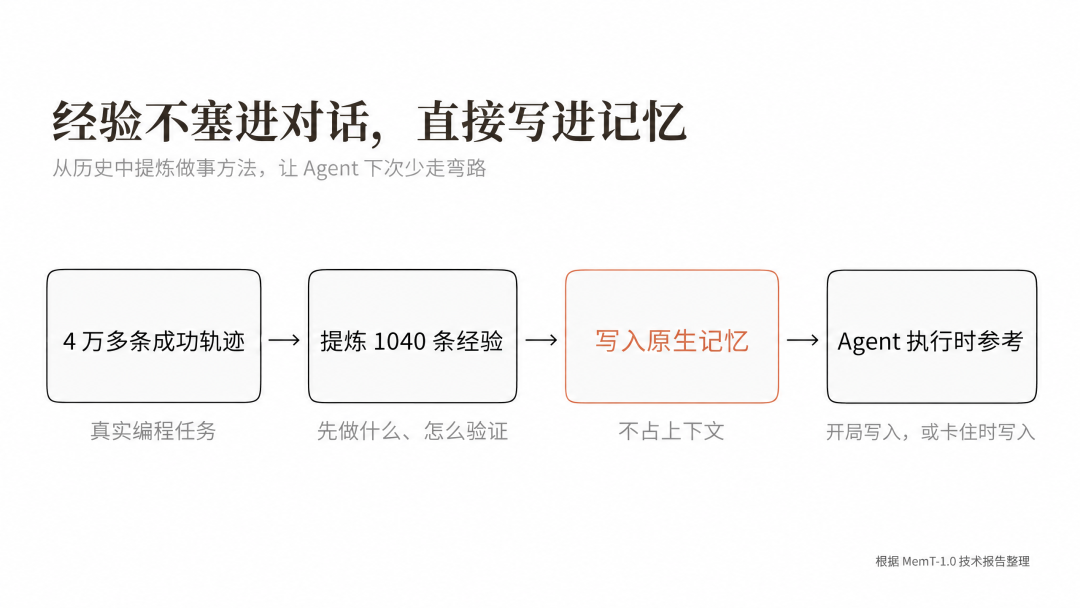
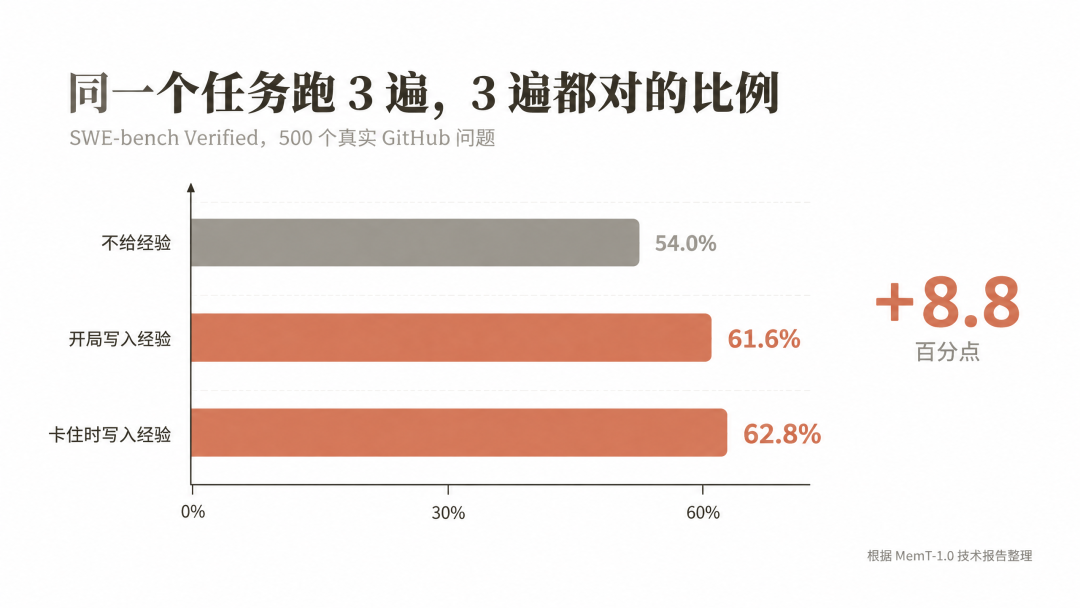
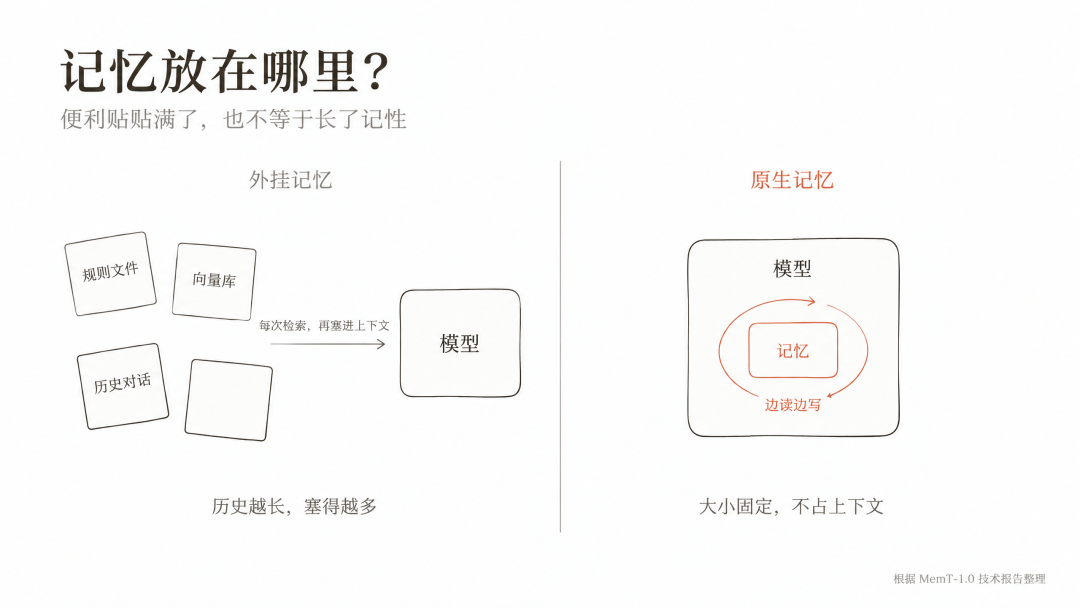
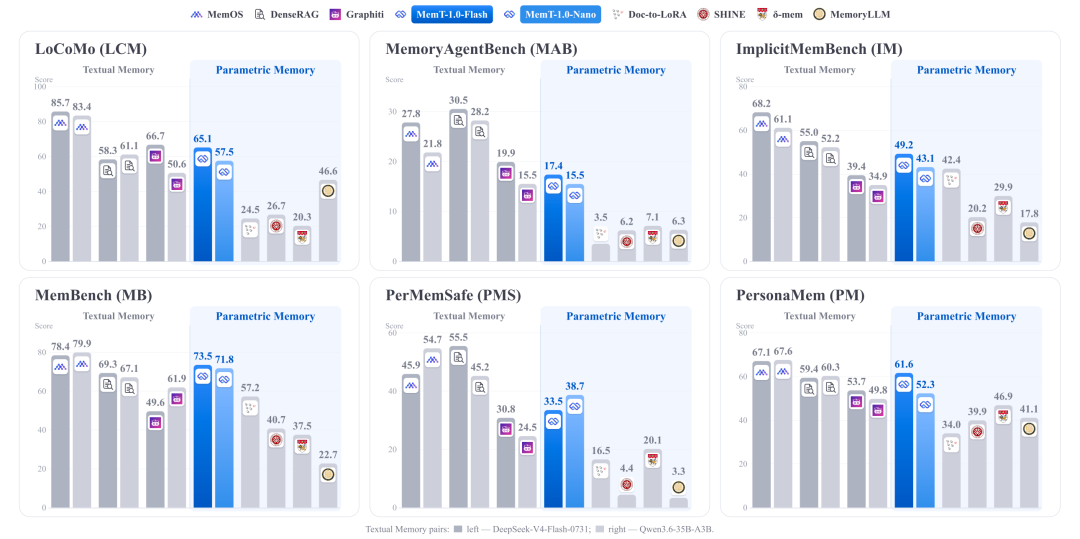
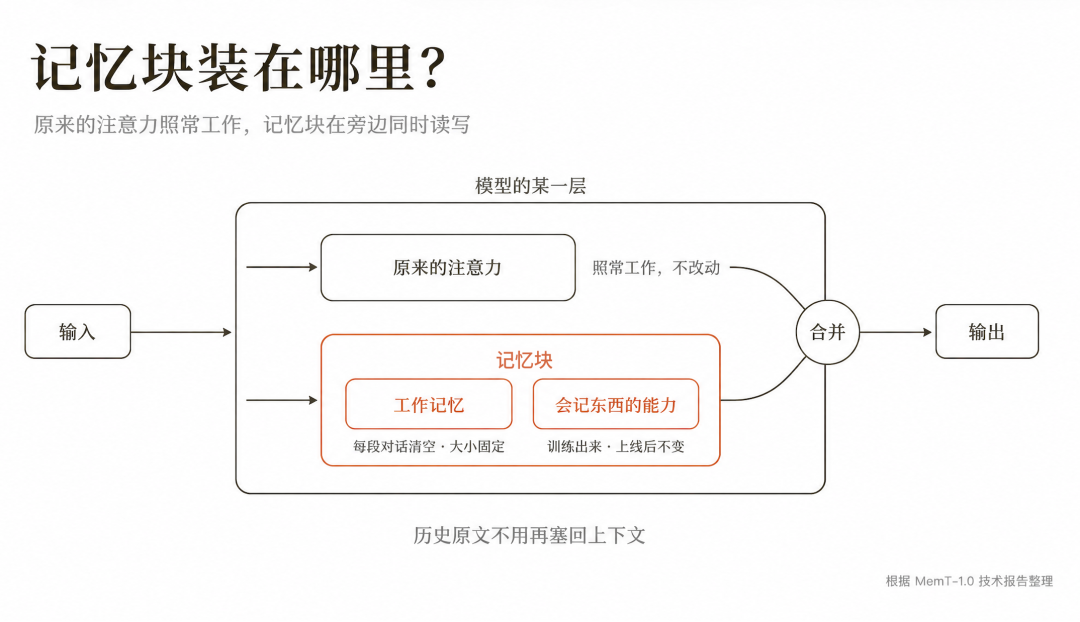
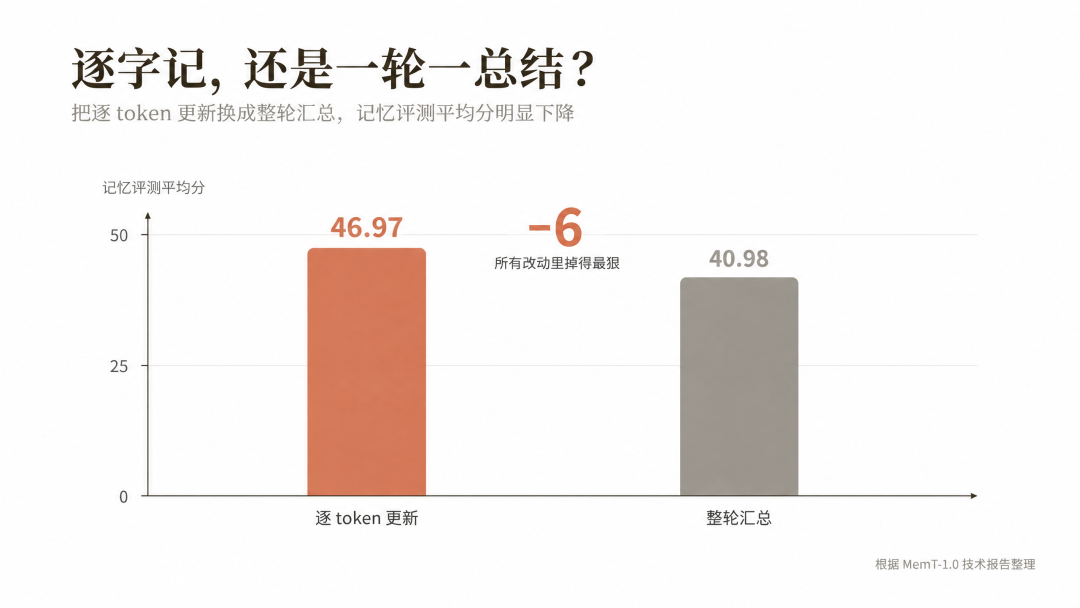
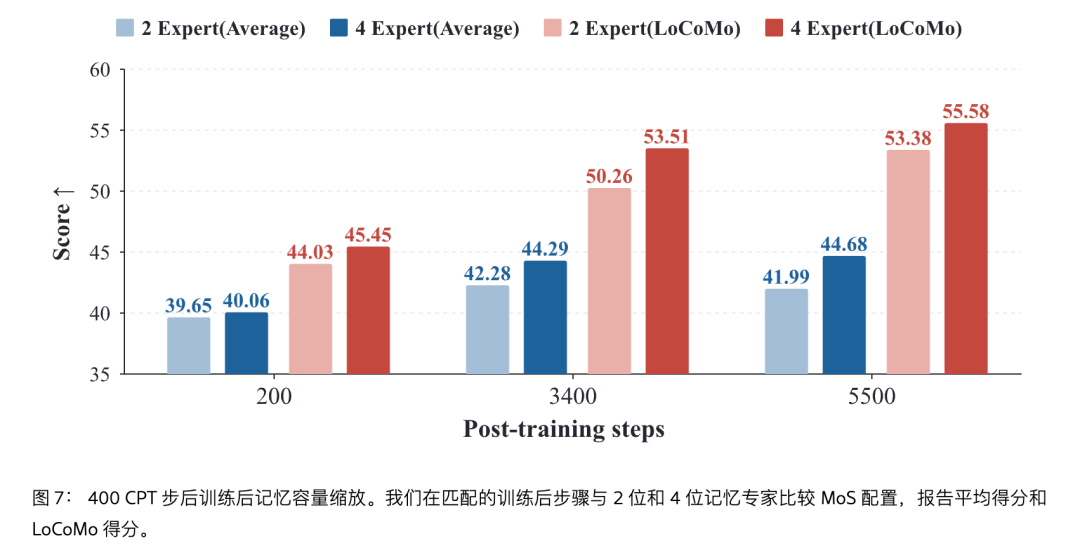
不知道你有没有发现,这半年大家聊 Agent,绕来绕去总会绕到同一个词上:记忆。Claude Code 有 CLAUDE.md,Hermes、OpenClaw 也各有各的记忆机制,专门做记忆的系统更是一个接一个冒出来。所有人都在想办法让 AI 多记住一点东西。10 月 20 日,MemOS 团队发了一个新模型...... 本文来自微信公众号: 林月半子的AI笔记 ,作者:林月半子聊AI,头图来自:AI生成 不知道你有没有发现,这半年大家聊 Agent,绕来绕去总会绕到同一个词上:记忆。 Claude Code 有 CLAUDE.md,Hermes、OpenClaw 也各有各的记忆机制,专门做记忆的系统更是一个接一个冒出来。所有人都在想办法让 AI 多记住一点东西。 10 月 20 日,MemOS 团队发了一个新模型,叫 MemT 1.0。我扫了一眼介绍,其中一句话让我停住了:他们想让“记住、更新、调用经验”变成模型自己能学会的能力。 不是给模型配一个更好的笔记本,是让记性直接长在模型里。 我第一反应是,这不就是我天天在跟它较劲的那件事吗? 我在 CLAUDE.md 里写了不少“不要再这样做”。它每犯一次错,我就补一条。规则越写越长,它有时照做,有时当没看见,同一个坑隔一周又踩一遍。 所以我挺想知道,把记忆从外面挪进模型里,真能治这个病吗? 这几天我把他们的技术报告从头到尾啃了一遍,几十页,公式不少。我重点盯了两组数据:一组是长对话下的速度和存储,另一组是把经验写进记忆之后,编程 Agent 能不能少犯重复的错。 MemTensor/MemT-1.0 的 GitHub 仓库,推理代码和技术报告都已公开 一个大尺寸、新架构的模型,开源一周多,日均下载超过 1 万,总量接近 10 万。看来盯着记忆这件事的人,不止我一个。 看完我的感觉是,它最值钱的地方不是让模型变聪明,而是让模型变靠谱。 先看结果:Agent 修 Bug 变了 报告里有个案例,我看完印象最深。 Django 里有个解析 HTTP 日期的函数,两位数年份的处理有 bug。他们让同一个编程 Agent 去修,对比了两种情况。 不带经验的 Agent:找到相关代码,直接动手改。改完了,才回头补复现测试、做验证。 带了经验的 Agent:先写一个复现测试,确认 bug 真的存在,再动手改。改完还回头检查了一个边界条件,发现不对,又修了一次,最后再补一轮验证。 看到这里我愣了一下。 "先写复现测试再改代码",这条我在 CLAUDE.md 里写过不止一次。区别在于,我是每次开会话都得把它塞进上下文,提醒 AI 照做;而这个 Agent 的对话里根本没有这条规则,它是自己"想起来"的。 这条经验,被写进了模型的记忆里。 具体怎么做的:他们先从 4 万多条成功的编程轨迹里,提炼出 1040 条可复用的"经验",比如遇到这类问题先做什么、怎么验证、要注意什么。Agent 开工时,或者执行到关键节点时,就把相关经验找出来。 关键在最后一步:经验不塞进对话,而是直接写进模型的原生记忆里。 一个案例说明不了太多,还得看整体数据。 他们拿 SWE-bench Verified 测,这是 500 个真实的 GitHub 问题。我最在意的不是平均成功率,而是一个叫 pass^3 的指标:同一个任务跑 3 次,3 次全对的比例。 为什么盯这个?用过 Agent 干正经活的人应该懂。最怕的不是它做不到,是它这次做到了、下次又做不到。 多语言版本的 SWE-bench 上也是同样的趋势,3 次全对的比例涨了 8 到 10 个点。而且效果和"把经验写成文字塞进上下文"基本持平,一点上下文都不占。 这里多说一句:3 次至少对 1 次的比例(pass@3)并没有明显提升。也就是说,经验没有让模型解出原本解不出的题,而是让它在能解的题上更稳。我觉得这个结论反而更可信。 问题来了:同样一条"先写测试再改代码",写在 CLAUDE.md 里时灵时不灵,写进模型记忆里却能稳定生效。差别到底在哪? 现在 AI 的记忆,几乎全是"外挂" 今天让 AI "记住"东西,招数其实就那么几种。 最简单的是写规则文件,CLAUDE.md、AGENTS.md 这一类,每次开会话先塞进去。复杂一点的上 RAG,把历史资料切块存进向量库,用的时候检索出来再塞。再往上,就是专门的记忆系统,从对话里抽取关键信息存起来,需要时召回。 招数不同,路子是一样的:记忆在模型外面,模型本身其实什么都没记住。 就像一个记性很差的同事,靠满桌子的便利贴干活。便利贴写得好,他就干得好;便利贴一多,他找都找不过来。 这套玩法用久了,有两个绕不开的问题。 一个是越用越慢、越用越贵。历史越长,每次要塞的东西越多,算力和等待时间一起往上涨。 另一个更要命:塞进去不等于学会了。规则读到了,下一步照不照做,看运气。 外挂记忆解决的是"把信息找出来",而不是"把经验变成习惯"。 刚才那个先写复现测试的 Agent,就像一个老程序员看到 bug 条件反射先写复现,不是因为他翻了笔记,而是这件事已经长在他的工作方式里了。 右边那条路,就是 MemT 1.0 想走的。 换个思路:把记性长进模型里 团队给它的定位是"记忆原生大模型"。 这次一口气放了两个尺寸。小的叫 Nano,36B 总参数,每次只用到其中 3B,底子是 Qwen3.6-35B-A3B。大的叫 Flash,288B,底子是二次后训练过的 DeepSeek-V4-Flash。 看到这两个底子我才反应过来:它不是从零训出来的新模型,而是在现成的开源模型上,加装了一套记忆。 在 11 项记忆评测里,两个模型在"把记忆练进模型"这类方法中排第一和第二。 蓝色区为"把记忆练进模型"的方法,MemT 两款在这一区最高 怎么加装的,我用自己的话翻译一下:在模型的一部分 Transformer 层里,额外挂了一个"记忆块"。这个记忆块分两部分: 一块是"工作记忆"。每开一个新会话时清空,之后每轮对话结束,模型就把新内容往里写一点、擦一点、忘一点。重点是:它的大小是固定的,不管你聊了 1 万字还是 100 万字,它就那么大。 另一块是"会记东西的能力"。这部分是训练出来的参数,决定了模型该记什么、该擦什么、该忘什么、用的时候怎么读出来。上线以后它就不动了。 拿人来类比会好懂很多。 "工作记忆"是你今天在这个项目里积累的上下文,项目换了就重来; "会记东西的能力"是你这么多年练出来的记性和判断力,换项目也带着走。 以前的大模型没有这套东西,全靠上下文临时记;MemT 1.0 是把两者都装进了模型本体。 生成回答的时候,模型的原始注意力照常工作,记忆块并行地从工作记忆里"读"出相关信息,两路结果加在一起往下算。历史原文不需要再塞回上下文里。 就这么个思路。 但真要做成,难点全在细节里。 它是怎么做到的:三个关键设计 报告里能讲的东西很多,我挑三个自己觉得最有意思的点,尽量说人话。 设计一:逐字记,而且要记得"稳" 开完一场会,你怎么补笔记?是凭印象写一段总结,还是把录音从头过一遍,一句一句往笔记里记? 大多数人都知道答案。写总结快,但细节早就糊了。 MemT 往记忆里写东西,时机是固定的:每轮对话结束后。区别在写法:是把这一轮压成一笔写进去,还是一个 token 一个 token 地更新。 直觉上,一轮写一次更省事。可报告里专门做了对比,把逐 token 更新换成整轮汇总,记忆评测的平均分直接掉了 6 分,是他们试过的所有改动里掉得最狠的。 逐个更新还有个好处:前面刚记下的东西,后面出现新说法,马上就能改过来。 不过这条路有个坑。 一轮对话动辄几千上万个 token,记忆就要跟着更新几千上万次。每次都是擦一点、写一点,次数一多,记忆里的数值很容易越滚越大,最后直接炸掉。 就像拿一块不太好用的橡皮,有时候不但没擦干净,反而把纸越擦越脏。 他们的办法是把这块"橡皮"重新设计了一遍,从数学上保证每擦一次,记忆只会变小、不会变大。这样更新再多次,也不会失控。 老程序员碎碎念:这种"跑久了才炸"的问题,做过后端的应该都很有体感。 线上服务跑一天没事,跑一周内存涨爆了。 能在设计上把这个口子堵住,而不是出了问题再靠调参硬压,这个我是真的服气。 设计二:记性的"容量",也能 scale 大模型能力增长,过去靠的是三样:参数、数据、上下文长度。 记忆原生模型多了一个维度:记忆容量本身。 他们设计了一个叫 Mixture-of-Storage 的结构,可以把一个记忆块扩成多个并行的"记忆专家",每个专家各管一摊,读写时按权重分配。 这次发布的模型每层还只用一个记忆专家,扩容是单独做的对照实验。实验结果挺干脆:4 个记忆专家在各个训练阶段都比 2 个专家强,而且训练越往后,差距拉得越大。 另外同一份数据多训一轮,记忆能力还在涨,没看到明显的天花板。 这条对做研究的人应该挺有吸引力:它说明记忆不是一个调好就封顶的模块,而是一条可以持续投入的路线。 设计三:账算得过来 这部分是我这种做过基础设施的人最关心的。 记忆原生模型最大的工程好处,是每个会话的记忆状态大小是固定的。 报告里拿 Nano 版本和"完整上下文"做了对比,我先看的是速度。 聊到 128K token 的时候,从处理历史到回答完,MemT 大约快了 1.86 倍。聊到 256K,差距拉到将近 4 倍。 更让我在意的是另一个数:每次提问,要等多久才出第一个字。 MemT 不管历史多长,基本都稳在 100 毫秒出头。完整上下文就不一样了,历史越长等得越久,到 256K 已经涨到 400 多毫秒。 历史越长,它越不慌。 存储这边的差距更夸张。每个会话需要持久保存的状态,128K 时比完整上下文少了约 66 倍,固定就是 40MB 左右,聊到 256K、1M 还是这个数。 为什么"状态大小固定"这么重要? 我以前做云原生的时候,最怕的就是那种"会话状态无限增长"的服务,容量规划根本没法做。 每个用户占多少存储、迁移一个会话要搬多少数据,能提前算出来,企业才敢大规模部署。 当然它也有代价:短历史场景下,算上写记忆的时间,它的端到端速度其实比完整上下文慢一些,32K 左右才追平。所以它真正的主场是"长期陪伴型"的应用。 想试试,从哪里入手 看到这里,你可能想问:这东西我现在能用上吗? 模型已经全部开源,Nano 和 Flash 两个版本的权重都放在 Hugging Face 上。 我的建议是先从 Nano 上手,每次只激活 3B,门槛低得多,两张 GPU 就能跑起来。 步骤很简单:先把 Nano 的权重从 Hugging Face 下载到本地,比如放在 /models/MemT-1.0-Nano;再把 GitHub 仓库拉下来,进到推理目录,执行启动脚本: cd inference sh start_memt_nano.sh /models/MemT-1.0-Nano 脚本后面那个参数,就是你刚才放权重的路径,换成自己的就行。 服务起来之后,最值得测的就是文章开头那件事:把你项目里反复强调的约束写进它的记忆,连跑几轮同类任务,看它是不是真的"记住了"。 写在最后 过去几年,大模型变强靠的是更多参数、更多数据、更长上下文。 MemT 1.0 想打开的是另一条路:让模型在用的过程中,把正确的经验沉淀下来。今天的经验,变成明天的能力。 报告标题里有个词说得很准:Memory-Native Evolution,记忆原生的进化。 当然,它也不是万能的。记忆大小是固定的,装不下所有细节,超长历史里要精确找回某句话,目前还是 MemOS 这类外挂记忆系统更靠谱。 所以我的判断是:原生记忆和外挂记忆不是谁替代谁,更像人的"经验"和"笔记本"。 精确的事实、长长的历史,交给笔记本去存和查;做事的方式、踩过的坑、项目的约束,慢慢沉淀成自己的习惯。MemOS 团队自己两条线都在做,大概也是这个意思。 路还长,但方向我是认的。 没有积累,就没有进步的复利。留不住的经验,成不了下一次的起点。 最后问一句:你的 AI 最让你崩溃的一次"失忆",是什么时候? 评论区聊聊。 以上。 本文来自微信公众号: 林月半子的AI笔记 ,作者:林月半子聊AI
🖼 相关图片